Kiến trúc ứng dụng AI gồm giao diện, backend, điều phối, mô hình, dữ liệu và giám sát. Tính năng phân loại đơn giản có thể chỉ cần API mô hình; trợ lý hỏi đáp cần thêm truy xuất và dẫn nguồn. Chọn thành phần theo luồng dữ liệu, quyền truy cập và rủi ro của bài toán.
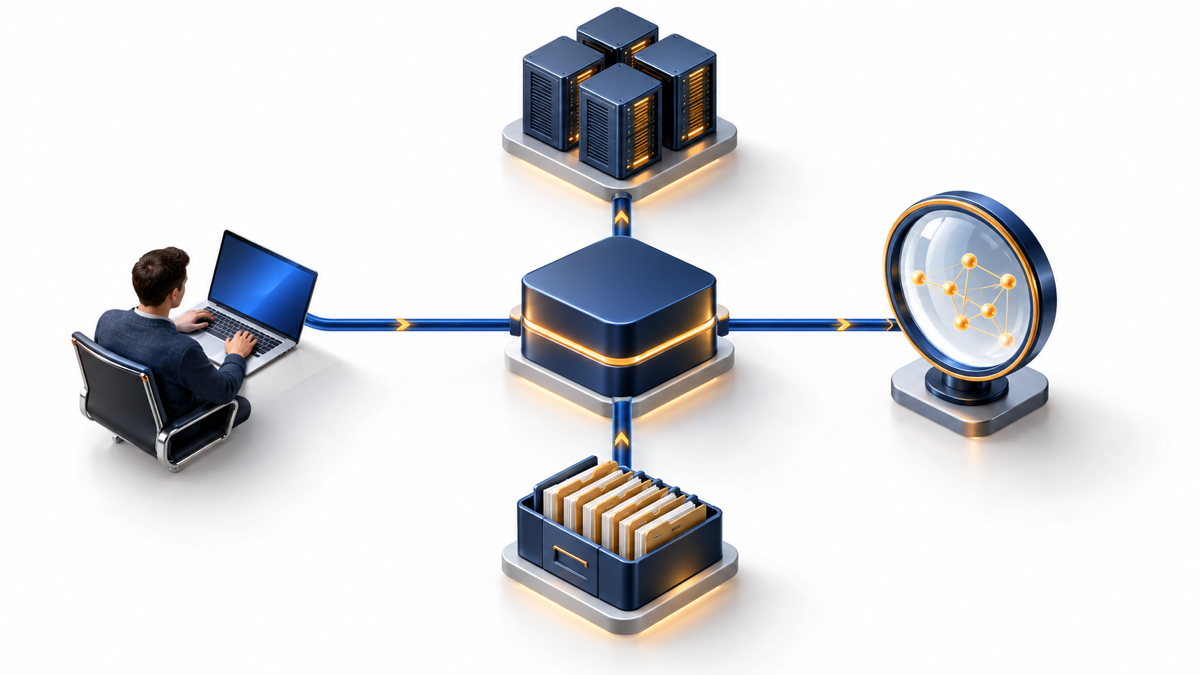
Sơ đồ tổng quát của ứng dụng AI
Ứng dụng AI là một hệ thống phần mềm có tích hợp một hay nhiều mô hình. Model chỉ là một thành phần: ứng dụng còn phải nhận yêu cầu, xác thực người dùng, chuẩn bị dữ liệu, gọi model, xử lý kết quả và đưa câu trả lời tới đúng nơi. Kiến trúc giúp xác định thành phần nào sở hữu từng trách nhiệm, dữ liệu đi qua đâu và khi lỗi xảy ra thì hệ thống phản ứng thế nào.
Luồng đơn giản có thể mô tả như sau: người dùng → giao diện → backend/API → điều phối → model hoặc dịch vụ dữ liệu → kiểm tra đầu ra → phản hồi. Các thành phần ngang như định danh, quản lý secret, logging, đo lường và giám sát đi cùng luồng. Không phải ứng dụng nào cũng cần vector database, hàng đợi tác vụ hay nhiều agent; mỗi dịch vụ bổ sung đều làm tăng chi phí vận hành và số điểm có thể hỏng.
Các thành phần chính trong kiến trúc ứng dụng AI
| Thành phần | Trách nhiệm | Câu hỏi thiết kế |
|---|---|---|
| Giao diện (client) | Nhận yêu cầu, hiển thị kết quả và trạng thái | Người dùng thấy nguồn, lỗi và giới hạn thế nào? |
| Backend/API | Xác thực, phân quyền, nghiệp vụ, điều tiết lưu lượng | Quyền nào được kiểm tra ở server? |
| Điều phối (orchestration) | Kết nối model, dữ liệu và các bước xử lý | Luồng nào chạy tuần tự, có nhánh hay cần duyệt? |
| Model endpoint | Sinh, phân loại, trích xuất hoặc embedding | Đầu vào/đầu ra, timeout và phương án lỗi là gì? |
| Kho dữ liệu | Lưu hồ sơ, tài liệu, metadata và kết quả | Ai được đọc, sửa, xóa và trong bao lâu? |
| Guardrail | Giới hạn nội dung, công cụ và hành động | Hành động nào cần xác nhận của con người? |
| Observability | Ghi nhận trace, metric và lỗi để điều tra | Đủ dữ liệu chẩn đoán mà không lộ thông tin? |
Giao diện và backend: nơi thực thi quyền hạn
Client có thể là website, ứng dụng di động, chatbot hoặc công cụ nội bộ. Nó nên chịu trách nhiệm về trải nghiệm nhập liệu, trình bày nguồn và thông báo lỗi dễ hiểu. Quyết định bảo mật không thể chỉ dựa trên giao diện: người dùng có thể bỏ qua client hoặc tự tạo request khác. Backend cần xác thực danh tính, xác nhận quyền trên từng tài nguyên và kiểm tra dữ liệu trước khi gọi model.
Khóa API của nhà cung cấp model nên được giữ ở môi trường server được kiểm soát, không nhúng vào mã frontend. Backend cũng là nơi áp dụng giới hạn tốc độ, kích thước đầu vào, timeout và quota. Nếu một người dùng chỉ được xem một tập tài liệu, bộ lọc quyền phải được thực thi trước lúc tạo ngữ cảnh, không đợi đến khi model trả lời mới yêu cầu “đừng tiết lộ tài liệu riêng”.
Lớp điều phối: nối quy trình, không thay nghiệp vụ
Orchestration điều phối thứ tự các bước: chuẩn hóa request, tìm dữ liệu, dựng prompt, gọi model, xác thực cấu trúc đầu ra và chuyển tiếp kết quả. Với tác vụ ngắn, một backend gọi API model có thể đủ. Workflow dài hơn có thể cần queue, lưu trạng thái, retry có giới hạn và cho phép tiếp tục sau gián đoạn. Một lớp điều phối rõ ràng giúp thay model hoặc cách tìm dữ liệu mà không phải viết lại toàn bộ giao diện.
Retry không nên thực hiện mù quáng. Lỗi tạm thời như timeout có thể thử lại với giới hạn; lỗi xác thực hoặc đầu vào sai cần sửa request. Với hành động có side effect như tạo đơn hàng, retry phải tránh tạo bản ghi trùng. Ghi nhận request ID, trạng thái từng bước và kết quả giúp đội ngũ biết tác vụ thất bại ở đâu.
Model và model gateway
Model có thể là dịch vụ API, mô hình được triển khai riêng hoặc mô hình chuyên dụng cho embedding, nhận dạng hình ảnh hay phân loại. Chọn model theo chất lượng trên bộ kiểm thử liên quan, độ trễ, cách xử lý dữ liệu, giới hạn tích hợp và chi phí tổng thể. Không chọn chỉ vì model đứng đầu trên benchmark không phản ánh tác vụ của ứng dụng.
Model gateway có thể tập trung việc định tuyến, áp quota, ghi log, chuyển model dự phòng hoặc chuẩn hóa giao diện nhà cung cấp. Đây không phải thành phần bắt buộc: nếu ứng dụng nhỏ chỉ dùng một endpoint ổn định, thêm gateway có thể làm tăng vận hành mà chưa tạo lợi ích. Khi có nhiều nhóm, model hoặc chính sách dùng chung, một lớp quản lý tập trung dễ chứng minh giá trị hơn.
Lớp dữ liệu và vòng đời nội dung
Ứng dụng có thể dùng cơ sở dữ liệu quan hệ cho tài khoản và giao dịch, object storage cho tệp, công cụ tìm kiếm cho văn bản hoặc vector database cho tìm kiếm tương đồng. Chọn nơi lưu theo kiểu truy vấn, yêu cầu cập nhật, xóa, khôi phục và phân quyền. Không dùng vector database chỉ vì ứng dụng có LLM; dữ liệu ít, câu hỏi từ khóa và yêu cầu đơn giản có thể phù hợp với tìm kiếm văn bản hiện có.
Với tài liệu nội bộ, pipeline nạp dữ liệu thường gồm kiểm tra quyền sử dụng, phân tích định dạng, chia đoạn, gắn metadata, lập chỉ mục và ghi phiên bản. Cập nhật nguồn phải loại hoặc thay đoạn cũ để hệ thống không trả lời từ bản hết hiệu lực. Metadata có thể gồm mã tài liệu, ngày hiệu lực, nhóm quyền và vị trí trích dẫn. Thiết kế quyền từ đầu giúp tránh phải sửa toàn bộ retrieval khi mở rộng nhóm người dùng.
Guardrail và phê duyệt
Guardrail là tập biện pháp kỹ thuật và quy trình để giảm rủi ro: kiểm tra đầu vào, giới hạn tool, xác thực schema, lọc nội dung đầu ra, bảo vệ dữ liệu và chuyển sang người xử lý. System prompt đơn lẻ không phải ranh giới bảo mật đáng tin cậy. Nếu model tạo SQL, HTML hoặc lệnh, backend cần xác thực và giới hạn thực thi theo quyền tối thiểu.
Mức kiểm soát phụ thuộc hậu quả. Gợi ý tiêu đề cho biên tập viên có thể chỉ cần xem trước; gửi email tới khách hàng, thay đổi hồ sơ hoặc thực hiện giao dịch cần bước phê duyệt và dấu vết kiểm toán. Khi hệ thống thiếu nguồn, gặp yêu cầu ngoài phạm vi hoặc không chắc quyền truy cập, hành vi an toàn có thể là từ chối, hỏi làm rõ hoặc chuyển cho nhân viên.
Monitoring và đánh giá chất lượng
Monitoring nên theo dõi ít nhất lỗi request, độ trễ, mức sử dụng, chi phí và tình trạng dịch vụ phụ thuộc. Với câu trả lời sinh, đánh giá thêm mức hữu ích, độ bám nguồn, định dạng và tỷ lệ phải chuyển người. Bộ đánh giá cần chứa câu hỏi thông thường, câu hỏi thiếu dữ kiện, tài liệu mâu thuẫn và yêu cầu ngoài phạm vi. Chạy lại bộ này khi thay model, prompt, dữ liệu hoặc logic truy xuất.
Trace cần đủ để lần theo request qua các bước, nhưng nội dung prompt và tài liệu có thể chứa dữ liệu nhạy cảm. Xác định trường nào cần che, ai được xem log và thời hạn lưu. Chỉ lưu log đầy đủ khi có mục đích và cơ chế kiểm soát phù hợp. Alert cần gắn với người xử lý và hành động, nếu không dashboard chỉ tạo thêm thông báo không ai phản hồi.
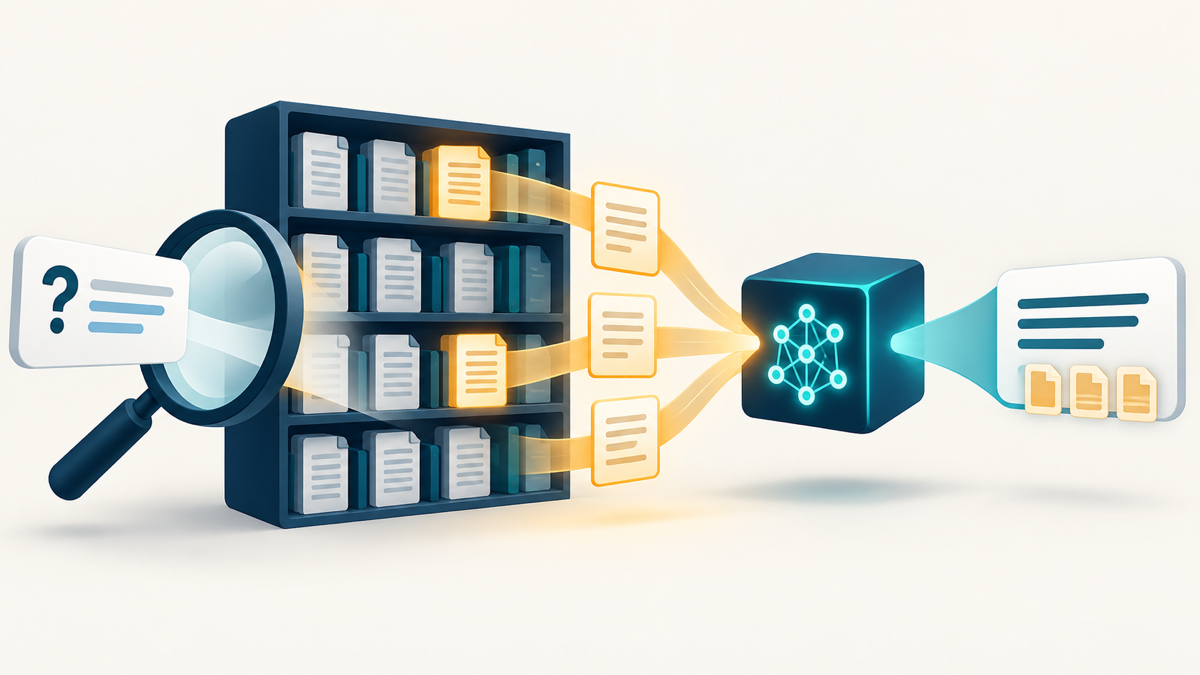
Ví dụ luồng RAG cho trợ lý tài liệu nội bộ
Giả sử nhân viên hỏi chính sách nghỉ phép. Backend xác thực tài khoản và lấy nhóm quyền; retrieval chỉ tìm trong tài liệu nhân viên đó được phép đọc; bộ điều phối chọn các đoạn phù hợp và gắn nguồn; model tạo câu trả lời dựa trên phần ngữ cảnh; bước hậu kiểm xác nhận định dạng và sự hiện diện của trích dẫn; giao diện hiển thị kết quả cùng liên kết tới tài liệu. Nếu không tìm thấy căn cứ đủ tốt, hệ thống nên nói chưa tìm được thay vì tự điền nội dung chính sách.
Kiểm thử cần bao gồm nhân viên có quyền, nhân viên không có quyền, tài liệu đã hết hiệu lực, câu hỏi mơ hồ và câu hỏi ngoài chính sách. Đo xem câu trả lời có dựa trên đúng đoạn nguồn hay chỉ trùng từ khóa. Thử prompt injection nằm trong tài liệu vì nội dung truy xuất cũng có thể chứa chỉ dẫn độc hại. Retrieval và guardrail giảm rủi ro nhưng không tự loại bỏ mọi tấn công; không cấp cho mô hình công cụ có quyền rộng hơn nhu cầu.
Chọn kiến trúc theo quy mô và mức rủi ro
Prototype: giao diện đơn giản, backend nhỏ, một model endpoint và bộ dữ liệu giả lập có thể đủ để xác nhận nhu cầu. Dùng dữ liệu thử, giới hạn người truy cập và ghi nhận lỗi. Không kết nối ngay hệ thống khách hàng hay tài khoản production chỉ để làm demo.
Pilot nội bộ: bổ sung định danh, phân quyền theo vai trò, tập đánh giá, logging được kiểm soát và quy trình phản hồi. Chỉ đưa một nhóm tài liệu hoặc người dùng vào thử. Xác định người chịu trách nhiệm khi câu trả lời sai và cách tạm dừng hệ thống.
Production: thiết kế dự phòng, quản lý secret, backup, quota, cảnh báo, quản lý phiên bản, kiểm thử hồi quy và kế hoạch rollback. Khi mức ảnh hưởng cao, cần đánh giá an ninh, quyền riêng tư, pháp lý và vận hành trước khi phát hành. Cấu phần cụ thể phải phù hợp kiến trúc hạ tầng hiện có; không có sơ đồ chung áp dụng cho mọi tổ chức.
Các bước thiết kế trước khi viết nhiều mã
- Viết một use case, nhóm người dùng, đầu ra mong đợi và trường hợp không hỗ trợ.
- Vẽ luồng dữ liệu từ client tới model và các kho; đánh dấu dữ liệu cá nhân, secret và điểm phân quyền.
- Chọn kiến trúc nhỏ nhất đáp ứng yêu cầu; ghi rõ tại sao cần từng thành phần.
- Tạo bộ câu hỏi và dữ liệu kiểm thử gồm ca chuẩn, ca biên và ca phải từ chối.
- Xác định metric, người nhận cảnh báo, cách dừng, cách rollback và chính sách log.
- Thử nghiệm trên pilot giới hạn, xem lại lỗi cùng người dùng rồi mới mở rộng.
Ví dụ prompt giao việc cho nhóm kỹ thuật: “Vẽ kiến trúc cho chức năng hỏi đáp tài liệu nhân sự. Nêu luồng request, nơi kiểm tra quyền, thành phần lưu nội dung, các lỗi có thể xảy ra và cách xử lý khi không tìm thấy nguồn. Không chọn công nghệ trước khi nêu yêu cầu; ghi các giả định cần xác minh.” Prompt này tạo đầu bài thảo luận, không thay thế phân tích threat model hoặc quyết định của kỹ sư phụ trách.
Các thuật ngữ trong sơ đồ kiến trúc
- Client: giao diện nhận câu hỏi và trình bày câu trả lời.
- Backend/API: kiểm tra danh tính, quyền và quy tắc nghiệp vụ.
- Orchestration: điều phối model, retrieval, tool và hậu kiểm.
- Model endpoint: nơi chạy model sinh hoặc dự đoán.
- Data store: kho hồ sơ, tệp, metadata và chỉ mục.
- Guardrail: giới hạn nội dung và hành động được phép.
- Observability: trace, metric và log có kiểm soát.
- Human review: điểm nhân viên xem và phê duyệt đầu ra.
Bài liên quan trên FUNiX
Câu hỏi thường gặp
Có phải ứng dụng AI nào cũng cần vector database?
Không. Nếu bài toán không cần tìm kiếm tương đồng trên tập nội dung, có thể dùng cơ sở dữ liệu hoặc tìm kiếm từ khóa hiện có. Chỉ thêm vector index khi có truy vấn thực tế cần semantic retrieval.
Có nên gọi model trực tiếp từ frontend?
Thông thường không nên dùng khóa API bí mật ở frontend. Backend giúp bảo vệ secret, kiểm tra quyền, áp quota và kiểm soát dữ liệu gửi tới nhà cung cấp.
Guardrail có ngăn model trả lời sai hoàn toàn không?
Không. Guardrail có thể giới hạn đầu vào, công cụ và đầu ra, nhưng cần kết hợp nguồn đáng tin, đánh giá, kiểm thử tình huống biên và người duyệt theo mức ảnh hưởng.
Khi nào cần thêm orchestration riêng?
Khi luồng có nhiều bước, nhánh điều kiện, retry, trạng thái chạy dài hoặc tích hợp nhiều nguồn. Một tính năng đơn giản có thể chỉ cần backend gọi model và kiểm tra phản hồi.
Monitoring ứng dụng AI nên theo dõi những gì?
Theo dõi lỗi, độ trễ, chi phí và tình trạng dịch vụ; với nội dung sinh, đo thêm độ bám nguồn, chất lượng trên bộ đánh giá và tỷ lệ phải chuyển cho người xử lý.
Kết luận
Thiết kế kiến trúc ứng dụng AI bắt đầu từ luồng dữ liệu, quyền và hậu quả của lỗi. Chọn số thành phần vừa đủ để giải quyết use case; bổ sung retrieval, gateway, hàng đợi hoặc agent khi yêu cầu cụ thể biện minh cho chúng. Dù dùng kiến trúc nào, cần kiểm tra quyền ở backend, đánh giá đầu ra và có cách xử lý khi hệ thống không chắc chắn.

Bình luận (0
)