Bộ công cụ học máy thường gồm Python và notebook để khám phá dữ liệu, pandas để xử lý bảng, scikit-learn cho nhiều mô hình truyền thống, PyTorch hoặc TensorFlow cho deep learning, Git để quản lý mã và MLflow để theo dõi thí nghiệm. Người mới nên chọn theo bài toán, không cần cài mọi thư viện cùng lúc.
Công cụ là từng mắt xích của workflow
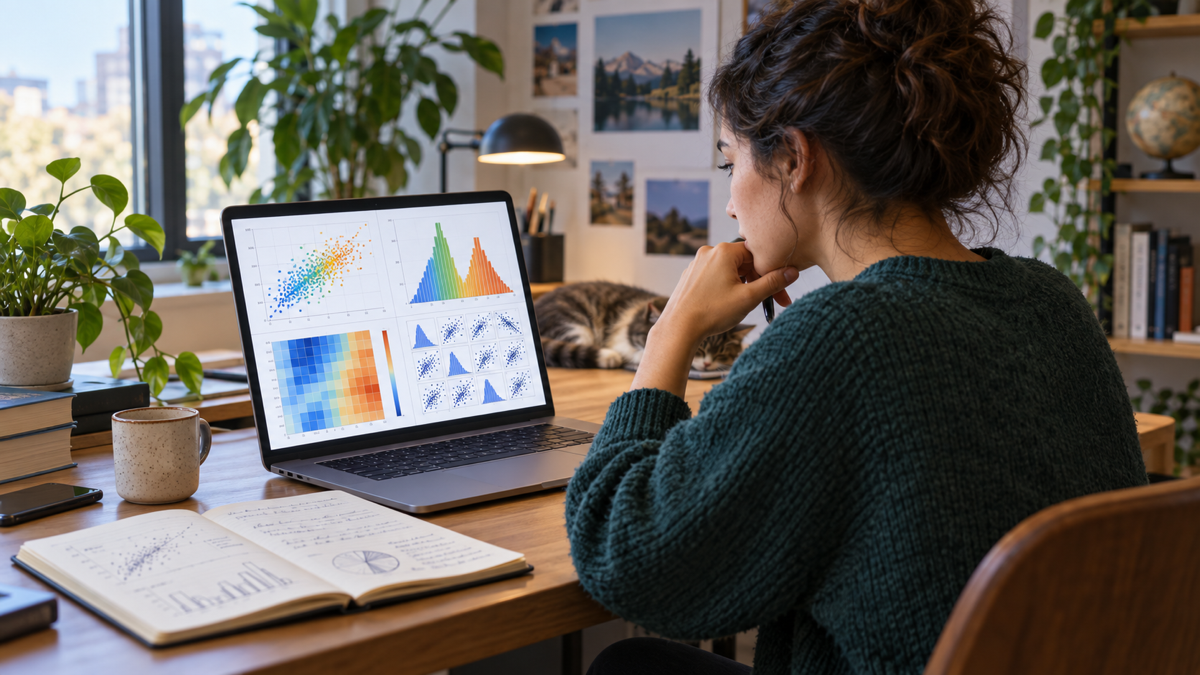
Một dự án học máy bắt đầu bằng câu hỏi cần trả lời và dữ liệu có thể dùng, không phải bằng việc chọn framework đang được nhắc nhiều. Sau đó nhóm khám phá chất lượng dữ liệu, tạo baseline, huấn luyện và đánh giá mô hình, quản lý phiên bản, đóng gói rồi mới đưa dự đoán tới người dùng hoặc hệ thống khác. Mỗi giai đoạn cần công cụ khác nhau.
“Công cụ học máy” cũng có thể chỉ phần mềm hỗ trợ người mới học thuật toán, nền tảng kéo-thả hoặc thư viện code cho chuyên gia. Bài viết tập trung vào stack phổ biến trong quy trình Python có mã nguồn, đồng thời nêu cách bắt đầu. Các nền tảng cloud, công cụ no-code và dịch vụ managed có thể phù hợp ở tổ chức cụ thể, nhưng không mặc định tốt hơn việc tự làm.
Bảng công cụ học máy theo giai đoạn
| Giai đoạn | Công cụ thường gặp | Dùng để | Khi chưa cần |
|---|---|---|---|
| Viết và thử mã | Python, JupyterLab/Notebook | Khám phá dữ liệu, thử giả thuyết, ghi chú | Không cần notebook cho mọi script production |
| Đọc và xử lý bảng | pandas, NumPy | Lọc, biến đổi, tính toán, kiểm tra dữ liệu | Tránh nạp toàn bộ dữ liệu lớn vào RAM nếu không phù hợp |
| Học máy truyền thống | scikit-learn | Pipeline tiền xử lý, phân loại, hồi quy, chọn mô hình | Không cần framework deep learning cho bảng nhỏ và baseline |
| Deep learning | PyTorch, TensorFlow/Keras | Mạng nơ-ron, xử lý tensor, GPU và huấn luyện tùy chỉnh | Không chọn chỉ vì bài toán có chữ “AI” |
| Quản lý mã | Git, nền tảng lưu repository | Lưu lịch sử thay đổi, review và hợp tác | Không thay cho quản lý dữ liệu/model artifact |
| Theo dõi thử nghiệm | MLflow hoặc công cụ tương tự | Ghi tham số, metric, model và artifact theo run | Cá nhân thử nhỏ có thể bắt đầu bằng ghi chép có cấu trúc |
| Phục vụ dự đoán | API framework, container, nền tảng triển khai | Đóng gói model thành dịch vụ hoặc batch job | Không cần triển khai online nếu dùng phân tích theo lô |
Python, pandas và notebook cho dữ liệu
Python được dùng rộng trong tài liệu học máy vì có hệ sinh thái thư viện và nhiều công cụ giúp thử nghiệm. Jupyter Notebook hoặc JupyterLab cho phép đặt mã, mô tả, bảng và biểu đồ trong cùng tài liệu; kiểu làm việc này hữu ích khi khám phá dữ liệu và chia sẻ quá trình phân tích. Khi notebook trở nên dài, phụ thuộc trạng thái chạy trước đó hoặc khó kiểm thử, chuyển logic ổn định thành hàm/module có thể giúp dễ bảo trì.
pandas và NumPy hỗ trợ các thao tác bảng và mảng số. Một luồng điển hình là đọc CSV hoặc Parquet, xem schema, đếm giá trị thiếu, kiểm tra kiểu và tạo đặc trưng. Không nên chỉ gọi một lệnh fillna cho mọi cột: thiếu tuổi, thiếu ghi chú và thiếu nhãn có nghĩa khác nhau. Tách train/test trước khi học các biến đổi cần fit giúp tránh rò rỉ thông tin từ tập kiểm tra vào quá trình huấn luyện.
Jupyter phù hợp với tác vụ khám phá, nhưng các cell có thể chạy không theo thứ tự và tạo ra kết quả phụ thuộc trạng thái RAM. Trước khi bàn giao, restart kernel và chạy lại notebook từ đầu; ghi phiên bản thư viện; đặt seed khi phép toán có yếu tố ngẫu nhiên và lưu nguồn dữ liệu được phép dùng. Với công việc lặp lại, đưa bước làm sạch và huấn luyện vào script hoặc pipeline được kiểm thử.
scikit-learn cho nhiều bài toán học máy truyền thống
scikit-learn cung cấp API nhất quán cho nhiều nhóm thuật toán như hồi quy, phân loại, clustering, giảm chiều và lựa chọn đặc trưng. Pipeline giúp nối bước tiền xử lý với estimator để chúng được áp dụng theo cùng quy trình ở lúc fit và dự đoán. Công cụ này thường là điểm bắt đầu tốt cho dữ liệu dạng bảng và baseline, đặc biệt khi người học muốn tập trung vào giả thuyết, feature và cách đánh giá.
Ví dụ dự đoán khách có rời dịch vụ hay không: định nghĩa biến mục tiêu, chia tập có kiểm soát theo thời gian hoặc phân tầng tùy dữ liệu, tạo baseline đơn giản rồi xem precision, recall, F1 hoặc ROC-AUC tùy chi phí của từng lỗi. Nếu dữ liệu mất cân bằng, accuracy cao vẫn có thể che giấu khả năng bỏ sót nhóm khách rời. So sánh các mô hình trên cùng tập và quy trình, không chỉnh tham số bằng cách liên tục nhìn vào tập test.
scikit-learn không tự giải quyết chất lượng dữ liệu, leakage hoặc tính hợp lệ của metric. Người thực hiện cần biết một hàng đại diện cho điều gì, liệu quan sát có độc lập, nhãn được tạo thế nào và kết quả có công bằng với các nhóm liên quan không. Tài liệu User Guide chính thức bao quát các họ mô hình và thực hành sử dụng; chọn thuật toán nên theo dữ liệu và tiêu chí hơn là theo độ phức tạp.
PyTorch và TensorFlow cho deep learning
PyTorch cung cấp tensor, automatic differentiation và module cho mô hình neural network; tài liệu Tutorials chính thức có các hướng dẫn để học cách xây và huấn luyện mô hình. TensorFlow có các API và hướng dẫn cho việc tạo model, huấn luyện và triển khai. Keras là API cấp cao có thể dùng trong hệ sinh thái TensorFlow và các backend được hỗ trợ theo tài liệu hiện hành. Cả hai hệ sinh thái đều phát triển; kiểm tra phiên bản, khả năng tương thích GPU và cách triển khai theo môi trường thật.
Không cần dùng deep learning cho mọi tác vụ. Nếu dữ liệu là bảng vừa phải và baseline tuyến tính hoặc cây quyết định trả lời được câu hỏi, mô hình phức tạp hơn có thể tăng chi phí huấn luyện, giải thích và vận hành mà không cải thiện kết quả đủ đáng kể. Deep learning phù hợp hơn khi bài toán có dữ liệu hoặc cấu trúc như hình ảnh, âm thanh, văn bản lớn, hoặc yêu cầu mô hình biểu diễn phức tạp; vẫn cần thử nghiệm và đo trên tập đánh giá đại diện.
Người mới cần học tensor shape, batch, loss, optimizer, gradient, train/validation loop và cách phát hiện overfitting. Khi GPU hết bộ nhớ hoặc quá trình chậm, hãy xem batch size, kích thước dữ liệu và profiling; cài thêm GPU framework trước khi hiểu nguyên nhân có thể tạo thêm lỗi driver. Nếu nhóm đã có codebase PyTorch hoặc TensorFlow, theo convention hiện hữu thường thực tế hơn việc chọn framework mới cho một bài tập nhỏ.
Git, MLflow và triển khai model
Git ghi lại thay đổi mã và hỗ trợ review, nhưng không tự quản lý mọi artifact lớn hoặc phiên bản dataset. Lưu thông tin nguồn dữ liệu, thời điểm trích xuất, schema và cách chia train/test theo cơ chế phù hợp. Không commit khóa API, dữ liệu cá nhân hoặc tập dữ liệu có điều khoản hạn chế vào repository.
MLflow Tracking ghi tham số, metric và artifact của các lần chạy thí nghiệm; Model Registry giúp quản lý các model đã đăng ký và phiên bản theo workflow của tổ chức. Một run có thể đại diện một lần thực thi chương trình huấn luyện. Khi nhóm cần so sánh nhiều thử nghiệm hoặc tái lập kết quả, tracking giúp biết metric đến từ mã, cấu hình và model nào. Với một bài tập cá nhân ngắn, file CSV có schema cố định cũng có thể đủ tạm thời; khi số thử nghiệm tăng, nên chuyển sang tracking có cấu trúc.
Đưa model vào sử dụng là một bước riêng. Online inference cần endpoint, kiểm tra request, quản lý phụ thuộc, giới hạn tài nguyên và theo dõi độ trễ; batch inference cần lịch chạy, nơi lưu kết quả và xử lý bản ghi lỗi. Đóng gói model trong container hoặc dùng công cụ serving giúp môi trường nhất quán hơn nhưng vẫn cần kiểm tra quyền truy cập, cập nhật image, logging và rollback. Đừng xem “model đã serialize thành file” là đã hoàn thành phần triển khai.
Ví dụ chọn stack theo một bài toán nhỏ
Giả sử nhóm phân tích muốn dự đoán thời gian giao hàng từ dữ liệu đơn hàng lịch sử. Bước đầu là xác định biến đích: thời gian tính từ lúc nào tới lúc nào, đơn bị hủy có nằm trong mẫu không và mục tiêu là hỗ trợ điều phối hay báo thời gian cho khách. Sau đó dùng Python/pandas để kiểm tra dữ liệu thiếu, ngày bất thường, đơn vị và các đơn trùng. Jupyter phù hợp để khám phá quan hệ giữa đặc trưng và target.
Tạo baseline bằng scikit-learn, dùng split theo thời gian nếu dữ liệu tương lai không được phép rò vào train, và đánh giá sai số theo nhóm tuyến hoặc phương thức vận chuyển. Nếu sai số ở một khu vực cao, điều tra chất lượng nguồn và số lượng mẫu trước khi chuyển sang mạng nơ-ron. Nếu cần lưu lại nhiều cấu hình, thêm Git và MLflow Tracking. Khi mô hình đủ hữu ích, mới tạo batch pipeline hoặc API theo cách nhóm tiêu thụ dự đoán. Bước sau phụ thuộc nơi dùng đầu ra, không phải mọi model đều cần endpoint 24/7.
Kết quả có thể cho thấy mô hình đơn giản đã đủ để xếp thứ tự ưu tiên nhưng chưa đủ đáng tin để hiển thị thời gian giao cho khách. Khi đó kiến trúc phù hợp là công cụ hỗ trợ nội bộ với người điều phối xem lại, không phải tự động cam kết thời gian. Nếu dữ liệu chưa đủ hoặc mục tiêu mơ hồ, dừng ở phân tích mô tả trước khi huấn luyện.
Lỗi thường gặp khi chọn công cụ
- Cài quá nhiều thư viện ngay đầu: chọn Python, pandas và một thư viện mô hình để hoàn thành baseline đầu tiên.
- Chạy theo framework phổ biến: kiểm tra cấu trúc dữ liệu, loại mô hình và convention của nhóm.
- Dùng notebook làm toàn bộ hệ thống: chuyển phần logic lặp lại thành module/testable script.
- Đo accuracy duy nhất: chọn metric theo hậu quả của false positive và false negative.
- Chỉ lưu file model: ghi kèm phiên bản mã, cấu hình, dữ liệu và cách đánh giá.
- Triển khai quá sớm: pilot trên dữ liệu đại diện, xác định rollback và người chịu trách nhiệm.
Đặt câu hỏi “công cụ này giải quyết điểm nghẽn nào?” trước khi thêm một dịch vụ. Nếu không thể mô tả lợi ích đo được hoặc lý do tương thích, giữ stack hiện tại và dành thời gian hiểu dữ liệu, metric cùng lỗi mô hình.
Các khái niệm cần phân biệt khi đọc tài liệu ML
- Ngôn ngữ: Python thường dùng trong ví dụ và thư viện ML.
- Notebook: môi trường kết hợp mã, giải thích và kết quả khám phá.
- Preprocessing: bước biến đổi dữ liệu trước khi fit mô hình.
- Estimator: thuật toán hoặc mô hình nhận dữ liệu để học/dự đoán.
- Metric: thước đo để so sánh đầu ra với mục tiêu.
- Run: một lần thực thi thử nghiệm có tham số và artifact.
- Model registry: nơi ghi nhận model và phiên bản theo workflow.
- Serving: cách cung cấp dự đoán theo request hoặc batch.
Bài liên quan trên FUNiX
- AI Engineer cần học gì? Bản đồ kỹ năng từ dữ liệu đến triển khai
- AI Engineer và Data Scientist khác nhau thế nào?
Câu hỏi thường gặp
Người mới nên học công cụ nào trước?
Bắt đầu với Python cơ bản, notebook và pandas để đọc dữ liệu; sau đó dùng scikit-learn cho một bài toán đơn giản. Học framework deep learning khi bài toán hoặc dự án cần nó.
Nên chọn PyTorch hay TensorFlow?
So yêu cầu dự án, codebase của nhóm, tài liệu, môi trường triển khai và hỗ trợ phần cứng. Nếu đang học, hoàn thành một mô hình nhỏ với một framework trước rồi so sánh qua nhu cầu thật.
Có phải học máy nào cũng cần GPU?
Không. Nhiều bài toán học máy truyền thống và dataset nhỏ chạy được trên CPU. GPU hữu ích với một số workload deep learning, nhưng cần kiểm tra tương thích và chi phí vận hành.
MLflow có bắt buộc cho dự án cá nhân?
Không. Khi mới thử ít cấu hình, ghi chép có cấu trúc có thể đủ. Tracking chuyên dụng hữu ích hơn khi nhiều run, model và thành viên cần so sánh hoặc tái lập kết quả.
Notebook có thể dùng để triển khai production không?
Notebook phù hợp khám phá và trình bày, nhưng logic production nên được kiểm thử, đóng gói và gọi qua workflow rõ ràng. Chạy lại từ đầu và loại phụ thuộc vào trạng thái cell trước khi bàn giao.
Kết luận
Chọn công cụ học máy theo giai đoạn: dữ liệu, baseline, mô hình, tracking và cách sử dụng dự đoán. Bắt đầu từ stack nhỏ nhất có thể giải quyết bài toán, đánh giá bằng dữ liệu đại diện rồi mới thêm framework hoặc hạ tầng. Năng lực thiết kế phép thử và hiểu lỗi quan trọng hơn số lượng công cụ đã cài.

Bình luận (0
)