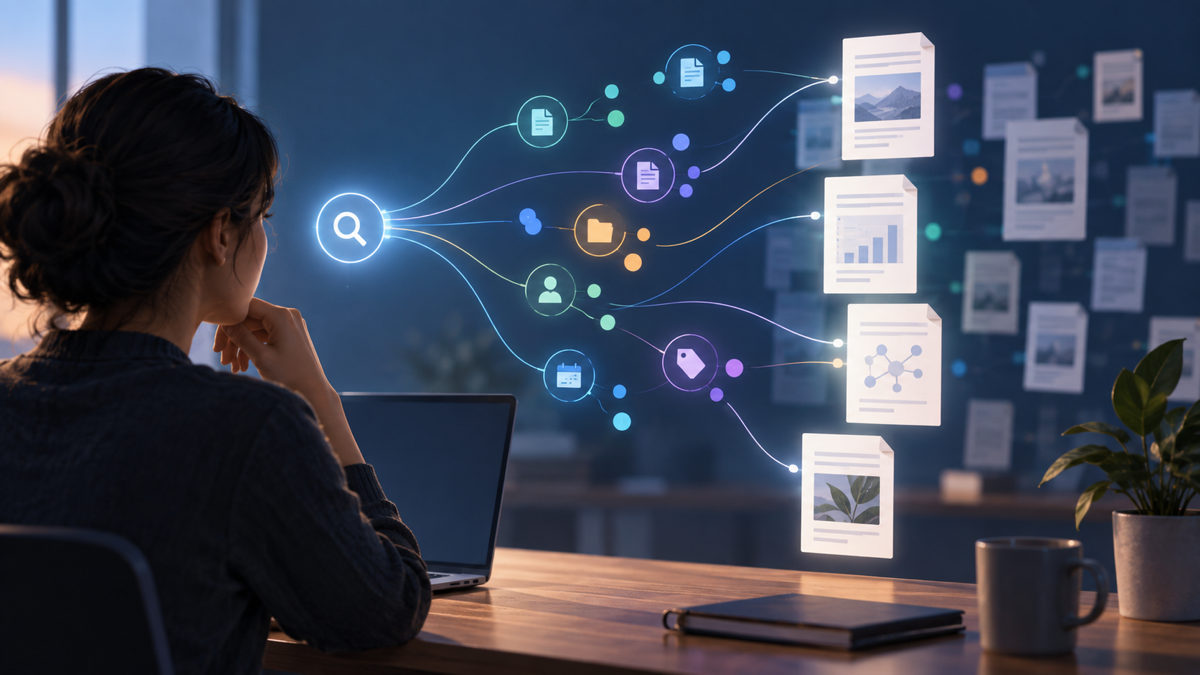
Vector database lưu embedding và metadata để tìm mục gần với truy vấn theo độ tương đồng. Trong RAG, ứng dụng lấy đoạn liên quan làm ngữ cảnh cho mô hình trả lời. Công cụ hữu ích khi cần semantic search trên tập nội dung phù hợp; dữ liệu nhỏ hoặc tra mã chính xác có thể chưa cần.
Vector database là gì và nó lưu gì?
Vector database là hệ thống lưu trữ và truy vấn dữ liệu biểu diễn bằng các dãy số gọi là vector. Trong ứng dụng văn bản, mỗi đoạn nội dung được đưa qua một mô hình embedding để tạo vector. Cơ sở dữ liệu có thể lưu vector, mã định danh, nội dung hoặc tham chiếu tới nội dung và metadata như tên nguồn, trang, thời điểm cập nhật hay nhãn quyền truy cập.
Khi nhận truy vấn, ứng dụng tạo embedding cho câu hỏi rồi tìm những vector gần nhất trong tập đã lập chỉ mục. Kết quả thường gồm nội dung liên quan và khoảng cách/điểm tương đồng theo metric đã chọn. “Gần” là quan hệ trong không gian embedding của model; nó không có nghĩa hai câu hoàn toàn đồng nghĩa hoặc câu trả lời lấy ra là đúng. Model embedding, dữ liệu, cách chia đoạn và metric đều ảnh hưởng tới thứ hạng.
Vector database không phải LLM. Nó không tự viết câu trả lời, không tự xác minh sự thật và không tự biết tài liệu nào được phép xem. Trách nhiệm đó thuộc những phần khác của ứng dụng: nguồn dữ liệu, bộ truy xuất, phân quyền, model sinh và bước đánh giá.
Embedding là gì và vì sao vector có thể tìm theo ý nghĩa?
Embedding là biểu diễn số do mô hình tạo ra từ một đầu vào như câu văn, đoạn tài liệu, hình ảnh hoặc âm thanh. Mục tiêu của từng model và kiểu dữ liệu khác nhau; vì vậy embedding từ hai model khác nhau không mặc nhiên so sánh trực tiếp được. Khi lập chỉ mục, ứng dụng cần dùng một cách nhất quán cho documents và query, đồng thời xem lại dữ liệu khi thay model hoặc phiên bản.
Ví dụ, tài liệu viết “nghỉ phép năm” và người dùng hỏi “còn bao nhiêu ngày phép” có thể gần nhau về ngữ nghĩa dù không dùng cùng cụm từ. Tìm kiếm từ khóa thuần có thể bỏ lỡ trường hợp này nếu từ ngữ khác nhau. Nhưng embedding cũng có thể xếp gần hai đoạn cùng nói về nghỉ phép trong bối cảnh khác nhau; do đó kết quả chỉ là ứng viên để kiểm tra, không phải kết luận chắc chắn.
Metric phổ biến gồm cosine similarity, dot product hoặc khoảng cách Euclidean, tùy cách model được huấn luyện và cách hệ thống cấu hình. Không nên lấy một ngưỡng similarity từ ví dụ trực tuyến làm chuẩn cho mọi model. Hãy tạo bộ truy vấn có kết quả mong muốn, xem các trường hợp đúng/sai và chọn cách xếp hạng dựa trên dữ liệu của mình.
Vector database trong một luồng RAG
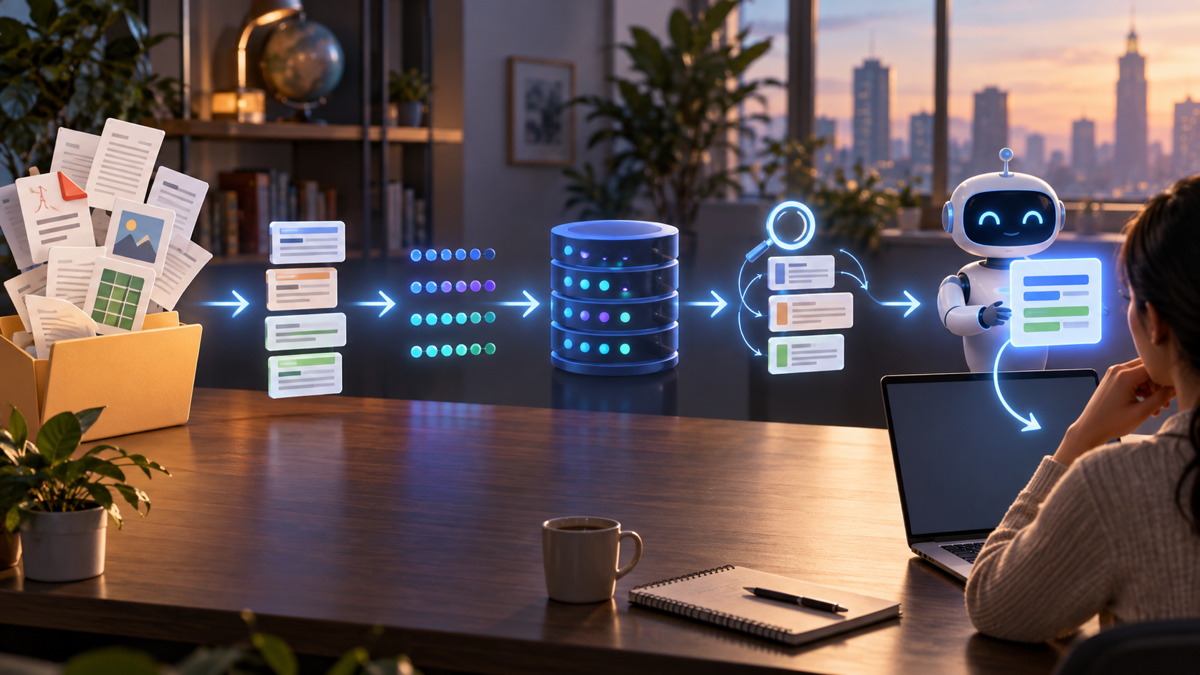
Với trợ lý hỏi đáp tài liệu, pipeline thường có hai pha. Ở pha ingest, ứng dụng lấy tài liệu, kiểm tra quyền và định dạng, chia thành các đoạn, tính embedding, rồi lưu vector cùng nội dung/metadata. Ở pha query, backend xác thực người dùng, tạo embedding cho câu hỏi, truy vấn database, lọc theo quyền và gửi một số đoạn liên quan cho model. Model sinh câu trả lời trên ngữ cảnh được cung cấp; giao diện có thể hiển thị nguồn để người đọc kiểm tra.
- Chọn nguồn: xác định tài liệu được phép sử dụng, người sở hữu và cách cập nhật.
- Chia nội dung: giữ các đoạn đủ ngữ cảnh, kèm mã nguồn và vị trí để trích dẫn.
- Tạo embedding: sử dụng model phù hợp với ngôn ngữ, loại dữ liệu và yêu cầu vận hành.
- Lập chỉ mục: lưu vector, văn bản hoặc URI, metadata và định danh ổn định.
- Truy vấn: embed câu hỏi, tìm ứng viên và áp bộ lọc trước khi đưa dữ liệu vào prompt.
- Đánh giá: kiểm tra đoạn được lấy, câu trả lời và nguồn trên tập câu hỏi thật.
Ví dụ công ty có hai thư mục: hướng dẫn chung cho mọi nhân viên và tài liệu lương chỉ dành cho nhân sự. Metadata như nhóm quyền phải gắn với từng đoạn. Khi nhân viên hỏi về lương, backend cần lọc quyền trước khi gửi bất kỳ nội dung nào cho model. Chỉ đặt câu “không tiết lộ tài liệu riêng” trong prompt không thể thay thế phân quyền ở hệ thống lưu trữ.
Vector search khác tìm kiếm từ khóa thế nào?
| Đặc tính | Vector search | Tìm kiếm từ khóa |
|---|---|---|
| Đối sánh | Gần nhau trong không gian embedding | Từ, cụm từ hoặc toán tử khớp với nội dung |
| Ưu điểm | Có thể tìm đoạn dùng cách diễn đạt khác | Hữu ích với mã, tên riêng và cụm chính xác |
| Hạn chế | Có thể trả đoạn “gần nghĩa” nhưng sai chi tiết | Có thể bỏ lỡ cách diễn đạt không trùng từ |
| Phù hợp | Câu hỏi ngôn ngữ tự nhiên, khám phá nội dung | Tra cứu ID, mã sản phẩm, tên hoặc từ khóa cụ thể |
| Kết hợp | Hybrid search có thể phối hợp tín hiệu semantic và từ khóa; cần đánh giá cách trộn xếp hạng. | |
Trong nhiều hệ thống, tìm kiếm lai hữu ích khi người dùng vừa hỏi bằng ngôn ngữ tự nhiên vừa cần tên riêng, mã hồ sơ hoặc số hiệu chính xác. Có thể truy xuất ứng viên bằng cả hai phương pháp, sau đó hợp nhất hoặc xếp hạng lại. Cách kết hợp tùy database và ứng dụng; cần kiểm tra tài liệu chính thức và đo trên truy vấn thực tế thay vì giả định hybrid luôn tốt hơn.
Những quyết định kỹ thuật ảnh hưởng kết quả
Chia đoạn và metadata
Đoạn quá ngắn có thể mất chủ ngữ hoặc điều kiện; đoạn quá dài có thể chứa nhiều chủ đề khiến model khó xác định căn cứ phù hợp. Chia theo cấu trúc tài liệu như tiêu đề, mục, câu hỏi và bảng thường giữ ngữ cảnh tốt hơn cắt theo số ký tự đơn thuần. Lưu tiêu đề cha, tên tài liệu và vị trí trang để kết quả có thể trích dẫn.
Cập nhật và xóa nguồn
Khi tài liệu đổi, cần cập nhật hoặc loại embedding cũ để retrieval không trả nội dung đã hết hiệu lực. Dùng ID ổn định và version/source timestamp để xác định đoạn thuộc phiên bản nào. Tài liệu bị thu hồi cần xóa khỏi index và cache liên quan theo chính sách lưu trữ. Cần thử luồng xóa, không chỉ luồng thêm mới.
Metadata filter và quyền truy cập
Metadata filter có thể giới hạn kết quả theo nhóm, loại tài liệu, khu vực hoặc thời điểm. Xác minh filter được áp dụng trên backend, với nguồn dữ liệu tin cậy, và không thể bị client sửa để mở rộng quyền. Nếu nội dung có quyền khác nhau, thiết kế partition/namespace hoặc filter theo khả năng database, rồi kiểm thử bằng tài khoản không có quyền.
Độ trễ và vận hành
Thời gian đáp ứng có thể đến từ tạo embedding, truy vấn vector, tải đoạn, gọi model và các hệ thống mạng. Đo từng pha giúp biết cần tối ưu ở đâu. Lập chỉ mục gần đúng có thể đổi tốc độ lấy ứng viên và độ chính xác; database managed giảm một số việc vận hành nhưng đem theo phụ thuộc dịch vụ, dữ liệu và chi phí riêng. Đọc tài liệu về backup, vùng lưu trữ, SLA và giới hạn gói tại thời điểm chọn.
Cách đánh giá chất lượng truy xuất
Tạo tập câu hỏi từ người dùng thật hoặc chuyên gia miền, rồi ghi những tài liệu/đoạn nào được xem là hữu ích. Đánh giá retrieval riêng với generation: trước tiên xem top-k có chứa bằng chứng cần thiết không; sau đó xem model có sử dụng đúng nội dung và giữ được giới hạn không. Nếu câu trả lời sai vì không có đoạn cần thiết, đổi prompt sinh chưa chắc giải quyết gốc rễ.
Ghi các loại thất bại: không truy xuất được dù có tài liệu; lấy nhầm phiên bản; thứ hạng tốt nhưng đoạn thiếu điều kiện; tìm thấy nguồn nhưng quyền lọc sai; hoặc truy xuất tốt nhưng model hiểu sai. Kiểm tra riêng câu hỏi có tên/mã chính xác, câu hỏi diễn đạt khác, câu hỏi không có đáp án và nguồn mâu thuẫn. Một bài demo tốt không đại diện mọi truy vấn.
Khi thay model embedding, cách chia đoạn, metadata schema hoặc metric, lập index có thể cần làm lại. Chạy cùng bộ đánh giá trước/sau để biết cải thiện ở nhóm nào và hồi quy ở nhóm nào. Ghi phiên bản cấu hình để có thể quay lại nếu chất lượng production giảm.
Khi nào vector database cần thiết và khi nào chưa?
Cân nhắc vector database khi có tập nội dung đủ lớn hoặc tăng thường xuyên, truy vấn cần tìm theo ngữ nghĩa, cần metadata filter, nhiều loại dữ liệu, hoặc hệ thống hiện tại khó đáp ứng độ trễ/quy mô. Cũng cần đội ngũ đánh giá embedding, quyền truy cập, index, cập nhật và backup. Chọn database theo cách triển khai mong muốn, lưu trữ, quyền, query pattern và năng lực vận hành chứ không chỉ vì tên sản phẩm.
Có thể chưa cần nếu tập nội dung chỉ vài chục file, người dùng tìm tên/mã chính xác, hoặc database hiện có hỗ trợ tìm kiếm đủ tốt. Có thể bắt đầu bằng một bộ sưu tập nhỏ, thử retrieval baseline và đo xem vector search cải thiện tỷ lệ tìm được bằng chứng hay không. Nếu không tạo khác biệt, giữ kiến trúc đơn giản và tránh thêm index cần đồng bộ.
Vector database không sửa được tài liệu sai hoặc dữ liệu truy cập không đúng quyền. Trước khi mở rộng, xác nhận nội dung nguồn chính xác, có ngày hiệu lực, cập nhật đúng và được phép sử dụng. Nếu kết quả không đáng tin, nguyên nhân có thể nằm ở tài liệu, chunking, model embedding, filter, query hoặc đánh giá — không chỉ do database.
Thuộc tính và thực thể
- Embedding: vector số đại diện đầu vào theo một model.
- Vector index: cấu trúc hỗ trợ tìm vector ứng viên theo metric.
- Metadata: thông tin lọc như nguồn, quyền, ngày hiệu lực hoặc vị trí.
- Chunk: đoạn nội dung được lập chỉ mục và truy xuất.
- Distance/similarity: điểm đo quan hệ giữa query vector và vector đã lưu.
- Top-k: số lượng kết quả được lấy để xử lý tiếp.
- Hybrid search: phối hợp tìm kiếm semantic và lexical.
- Re-index: tạo lại hoặc cập nhật index khi nguồn/cấu hình đổi.
Bài liên quan trên FUNiX
Câu hỏi thường gặp
Vector database có tự tạo câu trả lời không?
Không. Nó tìm và trả lại vector, nội dung hoặc metadata liên quan. Một model sinh và logic ứng dụng có thể dùng kết quả đó để tạo câu trả lời.
Vector database và RAG có giống nhau không?
Không. RAG là một quy trình kết hợp truy xuất thông tin với generation. Vector database có thể làm phần lưu/truy vấn vector trong quy trình, nhưng RAG còn gồm ingest, phân quyền, dựng context và đánh giá.
Vector search có luôn tìm đúng ý người dùng không?
Không. Kết quả phụ thuộc embedding, cách chia đoạn, dữ liệu, metric và filter. Hãy đánh giá top-k trên câu hỏi thật; khi cần mã chính xác, kết hợp tìm từ khóa.
Có thể lưu dữ liệu cá nhân trong vector database không?
Chỉ khi mục đích, quyền truy cập, lưu trữ, xóa và chính sách dữ liệu cho phép. Vector không mặc nhiên vô danh; kiểm tra dữ liệu gốc, metadata và dịch vụ đang dùng.
Khi nào nên lập chỉ mục lại?
Khi nguồn thay đổi, tài liệu bị thu hồi, schema metadata hoặc model embedding đổi. Cần có ID/version để thay đoạn cũ, tránh để kết quả obsolete tồn tại trong index.
Kết luận
Vector database giúp tìm nội dung gần nghĩa qua embedding, nhưng chất lượng phụ thuộc dữ liệu, model, chia đoạn, metadata và quyền truy cập. Thử bằng tập câu hỏi đại diện, so sánh với tìm kiếm từ khóa và chỉ đưa thêm hạ tầng khi semantic retrieval giải quyết một nhu cầu đo được.

Bình luận (0
)