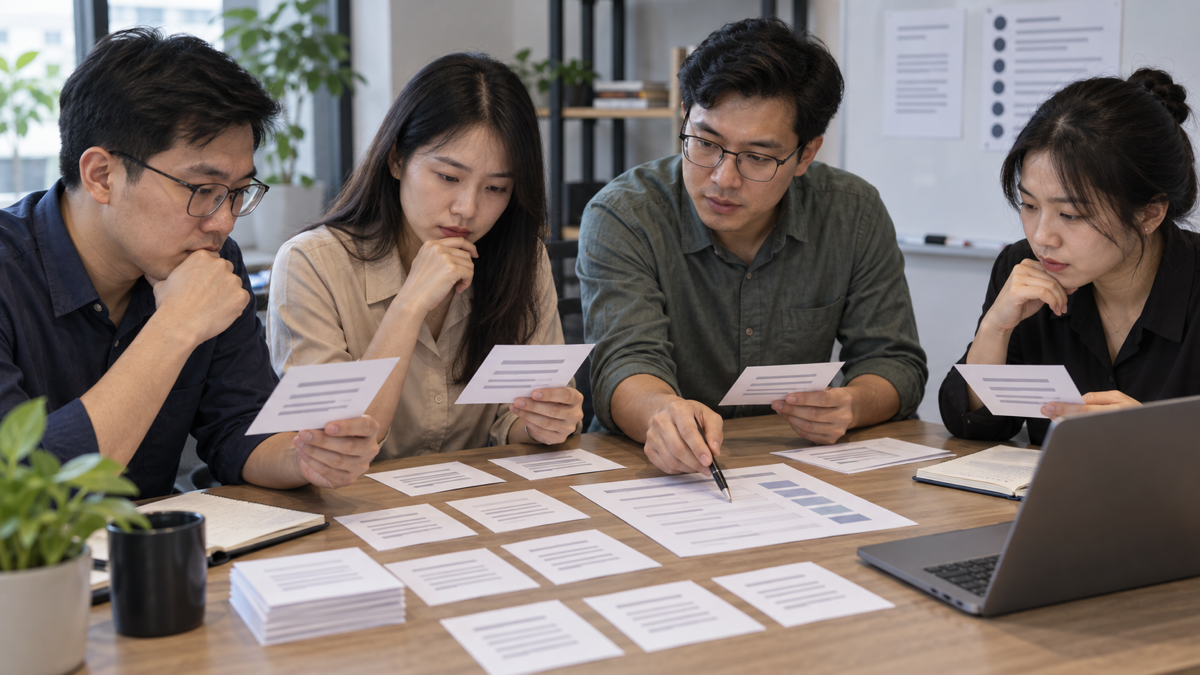
Dataset đánh giá LLM gồm đầu vào đại diện, hành vi mong đợi, tiêu chí rõ và ca biên phản ánh rủi ro. Hãy lấy ví dụ từ chuyên gia, phản hồi được phép dùng và tình huống tổng hợp; kiểm tra nhãn, tách tập phát triển với kiểm định, lưu phiên bản và bổ sung ca mới sau lỗi.
Dataset đánh giá LLM là gì?
LLM eval dataset là tập tình huống có cấu trúc dùng để kiểm tra ứng dụng hoặc prompt có đáp ứng mục tiêu đã định hay không. Một dòng dữ liệu thường chứa đầu vào, ngữ cảnh cần thiết và một hoặc nhiều thông tin tham chiếu như nhãn đúng, nguồn bằng chứng, tiêu chí chấm hay các hành động được phép. Cấu trúc cụ thể phụ thuộc nhiệm vụ; phân loại ticket cần nhãn, còn trả lời câu hỏi từ tài liệu có thể cần nguồn và tiêu chí groundedness.
Dataset không tự tạo ra một phép đánh giá đúng. Nếu ví dụ không đại diện, nhãn sai, hoặc metric không liên quan đến chất lượng người dùng cần, điểm số cao vẫn gây hiểu lầm. Hãy xác định trước điều gì khiến kết quả được chấp nhận và lỗi nào không thể chấp nhận được.
OpenAI Docs mô tả quy trình eval gồm xác định mục tiêu, thu thập dataset, định nghĩa metric, chạy so sánh và đánh giá liên tục. Hướng dẫn cũng khuyên bao gồm tình huống thường gặp, edge case và adversarial case, kết hợp dữ liệu chuyên gia, dữ liệu lịch sử và phản hồi phù hợp. Các con số ví dụ trong tài liệu không phải ngưỡng chuẩn cho mọi sản phẩm; nhóm phải tự đặt tiêu chí theo tác vụ.
Bắt đầu bằng mục tiêu đo
Viết mục tiêu dưới dạng hành vi quan sát được. “Model thông minh hơn” không phải mục tiêu có thể kiểm thử; “phân loại yêu cầu vào đúng một trong năm nhóm, không bịa nhãn ngoài danh mục” cụ thể hơn. Với trợ lý hỏi đáp nội bộ, mục tiêu có thể gồm trả lời đúng theo tài liệu, nêu nguồn, từ chối khi không đủ căn cứ và không lộ thông tin ngoài quyền.
Liệt kê cả mục tiêu tích cực lẫn điều cần chặn. Hệ thống tóm tắt cần giữ ý chính nhưng cũng không được tự thêm con số. Bộ trích xuất cần định dạng ổn định nhưng phải đánh dấu thiếu dữ liệu thay vì bịa. Bộ phân loại cần đúng nhãn và xử lý “không chắc” theo chính sách.
Lập taxonomy lỗi
Phân loại lỗi theo hậu quả giúp dataset tập trung vào rủi ro thay vì thu gom thật nhiều mẫu tương tự. Với bot hỗ trợ khách hàng, taxonomy có thể gồm sai chính sách, thiếu thông tin, trả lời ngoài phạm vi, tiết lộ dữ liệu, sai định dạng, hành động không được phép và câu hỏi mơ hồ. Mỗi lỗi nên có định nghĩa, ví dụ dương/âm và mức nghiêm trọng. Nhóm vận hành hoặc chuyên gia nghiệp vụ cần rà taxonomy trước khi gắn nhãn hàng loạt.
Đặt đơn vị đánh giá: một lời gọi, một lượt hội thoại, một quy trình nhiều bước hay một trace agent. Nếu chỉ chấm câu cuối, bạn có thể bỏ lỡ lỗi gọi tool sai dù câu trả lời sau đó nghe có vẻ đúng. Với quy trình agent, lưu các bước liên quan như tool được chọn, tham số, phản hồi và trạng thái cuối theo chính sách dữ liệu.
Thu thập tình huống đại diện
Nguồn dữ liệu có thể là ca do chuyên gia viết, lịch sử đã được phép dùng, phản hồi người dùng, báo cáo sự cố hoặc trường hợp tổng hợp có kiểm tra. Mỗi nguồn có thiên lệch riêng: log thường phản ánh người dùng hiện tại và các ca đã xảy ra, còn ví dụ viết tay có thể bỏ qua ngôn ngữ đời thường hoặc lỗi bất ngờ. Kết hợp nguồn giúp tăng độ phủ nhưng phải ghi provenance, mục đích sử dụng và điều kiện quyền riêng tư.
Chọn mẫu theo lát cắt quan trọng: intent, ngôn ngữ, độ dài, chất lượng dữ liệu, mức rủi ro, nhóm người dùng, tình huống thiếu ngữ cảnh và loại công cụ. Đếm số mẫu tổng thể không đủ; hãy kiểm tra phân bố và nhóm hiếm nhưng hậu quả cao. Không cân bằng dataset một cách mù quáng nếu điều đó làm sai tần suất thực tế; thay vào đó báo cáo điểm theo nhóm và giữ tập kiểm định phản ánh mục tiêu sử dụng.
| Nhóm ví dụ | Câu hỏi thiết kế | Ví dụ cho trợ lý tra cứu | Giá trị đánh giá |
|---|---|---|---|
| Happy path | Nhiệm vụ phổ biến, dữ liệu đủ là gì? | Câu hỏi chính sách có đoạn tài liệu rõ | Đo năng lực cơ bản |
| Thiếu dữ liệu | Khi nào cần hỏi lại hoặc từ chối? | Câu hỏi về quy định không có trong kho | Đo khả năng nhận biết giới hạn |
| Mơ hồ | Nhiều cách hiểu hợp lý? | “Tôi muốn đổi gói” nhưng không nêu gói nào | Đo hỏi làm rõ, tránh đoán |
| Đầu vào nhiễu | Lỗi chính tả, định dạng xấu, trộn ngôn ngữ? | Ảnh chụp OCR lỗi hoặc câu thiếu dấu | Đo độ bền ngoài dữ liệu sạch |
| Rủi ro cao | Điều gì cần chặn hoặc chuyển người? | Yêu cầu dữ liệu cá nhân không có quyền | Đo an toàn và phân quyền |
| Adversarial | Đầu vào có tìm cách vượt quy tắc? | Văn bản tài liệu yêu cầu bỏ qua chỉ dẫn hệ thống | Đo khả năng giữ chính sách |
Thiết kế schema và nhãn
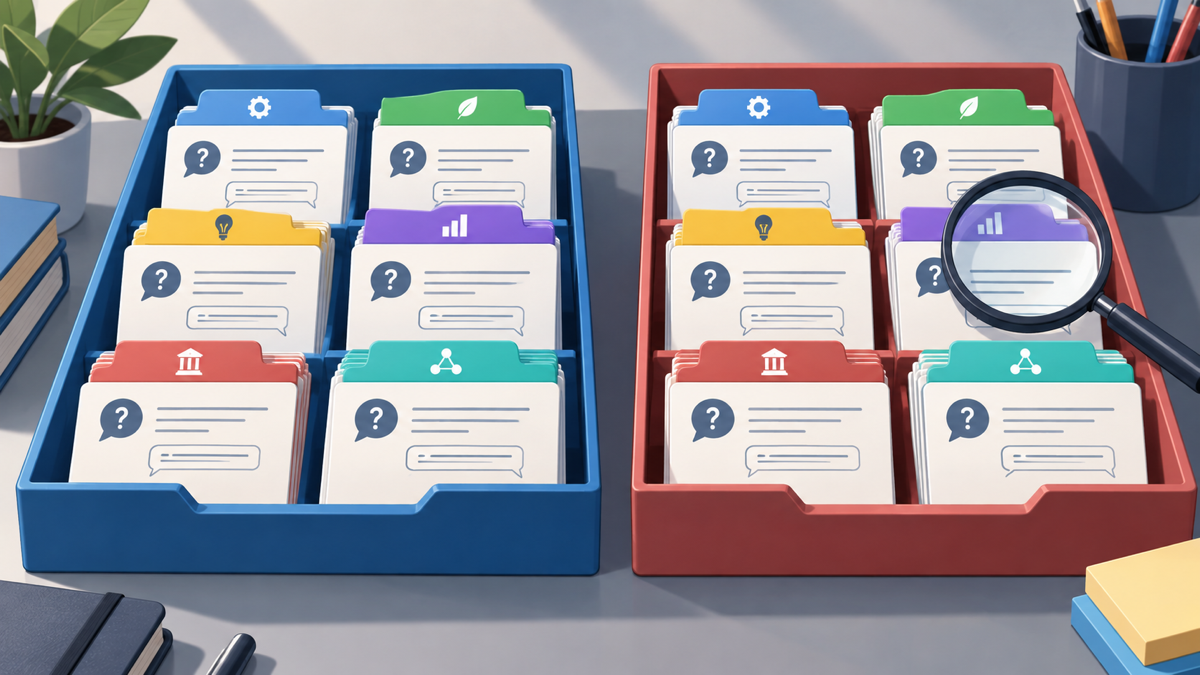
Schema phải chứa đủ dữ liệu để phát lại ca kiểm thử và xác định kết quả được đánh giá. Một schema gọn cho phân loại ticket có thể gồm case_id, input, expected_label, notes, split, source, risk_level và label_version. Ứng dụng cần ngữ cảnh thì lưu ngữ cảnh hoặc tham chiếu phiên bản tài liệu; không chỉ lưu câu hỏi đã tách khỏi nguồn.
Định nghĩa null và trường tùy chọn rõ. “Không có nhãn đúng” khác “người gắn nhãn chưa điền”. Với câu trả lời mở, một reference answer duy nhất thường quá cứng; có thể lưu các điểm bắt buộc, nguồn hỗ trợ, phản hồi chấp nhận được và điều bị cấm. Đối với output có cấu trúc, xác định trường bắt buộc, kiểu dữ liệu, quy tắc chuẩn hóa và cách chấm lỗi một phần.
Golden dataset không nhất thiết mỗi câu hỏi chỉ có một văn bản vàng. Nó là tập chuẩn được gắn nhãn có thẩm quyền theo định nghĩa của nhóm, có thể có nhiều câu trả lời hợp lệ hoặc rubric. Lưu giải thích cho ca khó để người gắn nhãn sau hiểu quyết định cũ; không để nhãn dựa vào cảm tính không được ghi lại.
Kiểm soát chất lượng nhãn
Viết hướng dẫn gắn nhãn với định nghĩa, ví dụ phản ví dụ, cách xử lý bất đồng và tiêu chí chuyển chuyên gia. Cho hai người độc lập gắn nhãn một phần tập khó; so sánh bất đồng, làm rõ hướng dẫn, rồi mới mở rộng. Không nên che bất đồng bằng cách lấy đa số khi hậu quả của nhãn cao hoặc câu trả lời phụ thuộc chuyên môn. Giữ nguồn và người/phiên bản quy trình tạo nhãn theo chính sách.
Định kỳ rà mẫu ngẫu nhiên, tập trung nhóm mới thêm và ca từng gây sự cố. Khi nhãn thay đổi, ghi lý do và version thay vì âm thầm ghi đè. Nếu dùng dữ liệu thật, hạn chế trường nhận diện, áp dụng quyền truy cập và lưu giữ thích hợp; đừng đưa dữ liệu nhạy cảm vào dataset chỉ vì tiện.
Chọn grader và rubric phù hợp
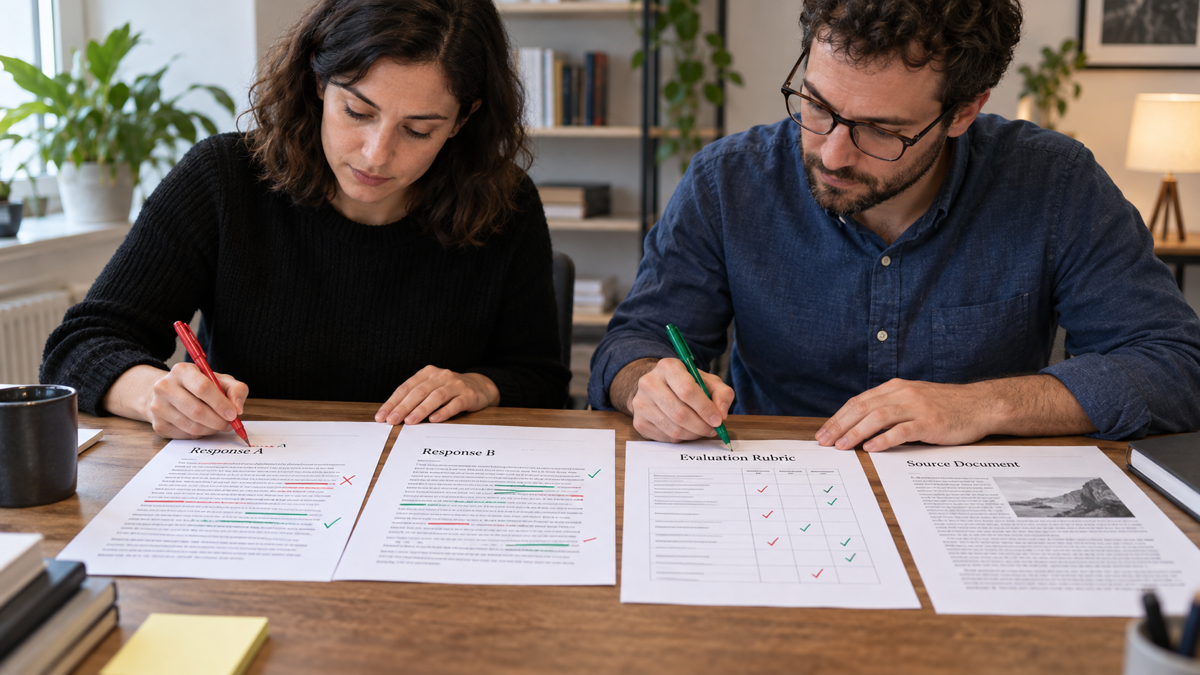
Grader phải kiểm tra đúng đặc tính cần đo. So khớp chuỗi phù hợp khi đầu ra có nhãn hoặc định dạng chính xác; kiểm tra bằng code phù hợp khi có quy tắc xác định; so với tham chiếu hoặc semantic similarity có thể dùng để sàng lọc nội dung nhưng không chứng minh tính đúng nghiệp vụ. Model grader có thể đánh giá tiêu chí mềm, song cần rubric rõ, ví dụ hiệu chỉnh và so sánh với nhãn người để biết mức đồng thuận.
OpenAI Evaluation Best Practices khuyến nghị thiết kế eval thiên về phân loại, so sánh cặp hoặc chấm theo tiêu chí cụ thể; tài liệu cũng lưu ý thiên lệch vị trí và độ dài khi dùng LLM làm giám khảo. Với lỗi nghiêm trọng, dùng kiểm tra deterministic hoặc người đánh giá thay vì dựa vào một model judge duy nhất. Báo cáo metric và mẫu lỗi, không chỉ một điểm tổng.
Chọn metric theo loại nhiệm vụ. Accuracy dễ hiểu nhưng có thể che nhóm hiếm; precision trả lời “trong các dự đoán dương, bao nhiêu đúng”, recall trả lời “trong các trường hợp thật, bao nhiêu được phát hiện”. Với nội dung mở, rubric có thể chấm độ đúng, đầy đủ, groundedness, an toàn và định dạng riêng. Trọng số phải phản ánh ưu tiên sản phẩm và được công bố cho nhóm.
Tách tập, versioning và tránh rò rỉ
Tập phát triển dùng để thử prompt, schema hoặc grader; tập kiểm định giữ kín hơn để ước lượng khả năng tổng quát hóa. Nếu liên tục xem điểm trên cùng tập kiểm định rồi sửa theo từng mẫu, tập này dần trở thành dữ liệu phát triển và kết quả mất tính độc lập. Có thể giữ thêm tập hồi quy chứa lỗi đã gặp để bảo vệ khỏi tái phát, nhưng nên phân biệt nó với tập holdout.
Tách dữ liệu theo người dùng, tài liệu, thời gian hoặc nhóm liên quan khi cần; chia ngẫu nhiên từng dòng có thể làm bản gần trùng xuất hiện ở cả train/dev/test. Kiểm tra duplicate, biến thể câu hỏi và nguồn chung. Với ứng dụng thay đổi theo thời gian, tập theo giai đoạn giúp phát hiện drift nhưng không thay thế bộ ca cố định để so sánh qua phiên bản.
Version hóa dữ liệu, schema, hướng dẫn nhãn, rubric và cấu hình chạy. Mỗi kết quả eval cần chỉ ra phiên bản model/prompt/tool, ngày chạy, tập dùng, metric, grader và thay đổi so với baseline. Khi một lỗi thực tế được bổ sung, ghi tag nguyên nhân và quyết định ca đó đi vào regression set hay holdout. Thay đổi nhãn phải làm kết quả cũ có thể giải thích lại.
Lưu ý sản phẩm OpenAI tại ngày 28/09/2026: tài liệu OpenAI thông báo nền tảng Evals sẽ chuyển eval hiện có sang read-only ngày 31/10/2026 và dự kiến đóng dashboard/API ngày 30/11/2026. Vì vậy, bài này mô tả nguyên tắc thiết kế dataset có thể dùng với nhiều công cụ; nếu đang phụ thuộc Evals platform, cần xem thông báo chính thức và lập kế hoạch chuyển đổi, không mặc định API cũ tiếp tục khả dụng sau các mốc đó.
Ví dụ dataset phân loại ticket
Với yêu cầu phân loại ticket hỗ trợ vào nhóm thanh toán, tài khoản, kỹ thuật hoặc khác, một record có thể chứa input đã làm sạch, nhãn do chuyên gia xác nhận, lý do ngắn, risk tag, split và version nhãn. Tạo ca chuẩn, ca gần ranh giới giữa hai nhãn, ca thiếu thông tin, câu viết sai chính tả và câu cố yêu cầu output ngoài danh mục. Thêm expected behavior cho ca không đủ dữ kiện, chẳng hạn nhãn “cần làm rõ” nếu sản phẩm cho phép.
{
  "case_id": "ticket-042",
  "input": "Tôi bị trừ tiền hai lần cho cùng một đơn",
  "expected_label": "billing",
  "expected_behavior": "trả đúng một nhãn trong danh mục",
  "risk_level": "normal",
  "split": "regression",
  "label_version": "v3",
  "source": "synthetic-reviewed"
}
Đây chỉ là ví dụ schema; tên trường và nhãn phải phản ánh ứng dụng. Nếu ticket có nội dung cá nhân hoặc log thật, cần xác minh quyền sử dụng trước khi lưu. Chạy baseline trước, xem từng lỗi, sau đó sửa prompt hoặc code và chạy lại cùng phiên bản data để so sánh. Nếu điểm tổng tăng nhưng lỗi nghiêm trọng tăng, thay đổi chưa thể coi là cải thiện.
Câu hỏi thường gặp
Cần bao nhiêu mẫu để bắt đầu?
Không có con số chung bảo đảm đủ đại diện. Bắt đầu bằng các ca phổ biến, ranh giới và rủi ro cao; xem đường cong lỗi và độ biến thiên qua nhiều lần chạy. Tăng mẫu khi một lát cắt quá ít dữ liệu hoặc kết quả chưa ổn định.
Golden dataset có phải một đáp án chuẩn duy nhất?
Không nhất thiết. Với phân loại có thể có nhãn chuẩn; với câu trả lời mở, chuẩn có thể là nguồn bằng chứng, điểm bắt buộc, rubric và nhiều cách diễn đạt chấp nhận được. Quan trọng là người đánh giá hiểu tiêu chí giống nhau.
Có thể dùng dữ liệu tổng hợp không?
Có thể dùng để mở rộng tình huống hoặc kiểm tra ca hiếm, nhưng cần chuyên gia rà độ hợp lý và tránh để tập chỉ chứa văn phong giả lập. Kết hợp với dữ liệu được phép sử dụng và kiểm tra trên phân bố gần thực tế.
LLM-as-a-judge có thay người gắn nhãn?
Không mặc định. Model grader hữu ích ở quy mô lớn nhưng có thiên lệch và bất đồng. Hiệu chỉnh rubric bằng ví dụ người gắn nhãn, đo mức đồng thuận và dùng review con người cho ca rủi ro cao hoặc bất đồng.
Khi nào cập nhật dataset?
Bổ sung khi có intent mới, thay đổi sản phẩm, lỗi thật, drift dữ liệu hoặc lỗ hổng trong coverage. Mỗi cập nhật cần provenance, version và kiểm tra duplicate để kết quả các lần chạy còn diễn giải được.
OpenAI Evals còn dùng được đến khi nào?
Theo thông báo chính thức hiện tại, evals hiện có thành read-only từ 31/10/2026 và dashboard/API dự kiến đóng ngày 30/11/2026. Đây là lịch có thể thay đổi; nhóm dùng sản phẩm cần kiểm tra trang deprecations chính thức và chuẩn bị phương án chuyển.
Nguồn tham khảo
- OpenAI — Evaluation best practices — quy trình, nguồn dữ liệu, metric, continuous evaluation, edge case và model grader.
- OpenAI — Working with evals — schema dataset, testing criteria, nhãn ground truth và quy trình chạy.
- OpenAI — Deprecations — lịch chuyển Evals platform được công bố.

Bình luận (0
)