Đo hiệu quả AI Agent bằng cách kết hợp chất lượng, tỷ lệ hoàn thành, thời gian, chi phí, lỗi và chuyển người. Chọn KPI theo nhiệm vụ, định nghĩa mẫu số và tiêu chí trước khi thử. So sánh với baseline trên tình huống đại diện, tính cả công sức review và báo riêng lỗi nghiêm trọng.
Bắt đầu từ nhiệm vụ
Trước khi chọn KPI, mô tả nhiệm vụ mà agent đảm nhận, người dùng, đầu vào được phép, đầu ra mong muốn và điểm dừng. “Agent xử lý hỗ trợ khách hàng” quá rộng để đo. “Agent tra cứu câu hỏi chính sách trong kho tài liệu đã duyệt, tạo câu trả lời có trích dẫn và chuyển nhân viên khi không tìm thấy nguồn” cụ thể hơn vì có thể kiểm tra tính đúng, nguồn, tỷ lệ chuyển tiếp và thời gian.
Đơn vị đo nên tương ứng với công việc. Đó có thể là một câu hỏi, một hồ sơ, một phiên giao dịch hoặc một workflow đã kết thúc. Định nghĩa rõ một nhiệm vụ được tính hoàn thành khi nào, thế nào là từ chối đúng, thế nào là chuyển người hợp lệ và có tính các lượt thử lại hay không.
Đo với một mục tiêu ra quyết định. Nhóm có thể muốn biết agent giảm thao tác lặp lại không, có đáp ứng chất lượng tối thiểu không, hay có làm tăng tải kiểm tra của nhân viên không. Những câu hỏi khác nhau cần chỉ số khác nhau. Việc gom tất cả thành điểm “hiệu quả AI” thường che khuất trade-off giữa tốc độ, độ chính xác, chi phí và rủi ro.
Nhóm KPI nên theo dõi
- Chất lượng đầu ra: mức phù hợp với đặc tả, độ chính xác dữ kiện, tính đầy đủ, nguồn có hỗ trợ kết luận không và tỷ lệ lỗi theo mức độ nghiêm trọng.
- Hoàn thành nhiệm vụ: số việc đạt tiêu chí hoàn thành trên tổng số việc đủ điều kiện; tách rõ hoàn tất tự động, hoàn tất sau chỉnh sửa và hoàn tất sau chuyển người.
- Chuyển tiếp/escalation: tỷ lệ agent chuyển đúng trường hợp cần người, tỷ lệ chuyển nhầm và các yêu cầu đáng lẽ phải chuyển nhưng agent tự trả lời.
- Thời gian: thời gian tới kết quả, thời gian nhân viên đọc/sửa, thời gian chờ người duyệt và tổng thời gian để hoàn tất. Thời gian phản hồi nhanh không đồng nghĩa công việc kết thúc sớm.
- Chi phí: chi phí model và dịch vụ, cộng hạ tầng, đánh giá, vận hành và công sức review nếu tổ chức cần tính tổng chi phí. Nêu rõ phạm vi và kỳ tính.
- An toàn và độ tin cậy: lỗi quyền truy cập, trích dẫn sai, hành động vượt quyền, sự cố dữ liệu, lỗi lặp lại và mức độ ảnh hưởng.
- Mức chấp nhận của người dùng: tỷ lệ sử dụng tiếp, phản hồi người dùng, tỷ lệ sửa đầu ra và mức tin cậy được đo bằng phương pháp xác định. Không suy diễn sự hài lòng chỉ từ số lần mở chatbot.
| Chỉ số | Định nghĩa ví dụ | Cạm bẫy khi đọc |
|---|---|---|
| Tỷ lệ hoàn thành đạt chuẩn | Nhiệm vụ đạt toàn bộ tiêu chí chất lượng ÷ nhiệm vụ đủ điều kiện đã xử lý. | Không tính đầu ra cần sửa là hoàn thành tự động; nêu rõ mẫu số và tiêu chí. |
| Chất lượng câu trả lời | Điểm theo rubric về đúng, đủ, có nguồn và đúng phạm vi trên mẫu được chấm. | Điểm tổng có thể che nhãn yếu; xem kết quả theo nhóm tình huống và mức rủi ro. |
| Tỷ lệ chuyển người đúng lúc | Trường hợp phải chuyển và agent chuyển ÷ tổng trường hợp được đánh giá là cần chuyển. | Chuyển nhiều chưa chắc tốt; cần xem bỏ sót và chuyển thừa cùng lúc. |
| Thời gian tiết kiệm ròng | Thời gian baseline trừ thời gian mới, bao gồm review, sửa và xử lý lỗi. | Đo riêng thời gian model tạo kết quả sẽ bỏ công việc của nhân viên. |
| Chi phí trên nhiệm vụ đạt chuẩn | Tổng chi phí trong phạm vi đã chọn ÷ số nhiệm vụ đạt chuẩn. | Chi phí đầu ra lỗi vẫn có thể phát sinh; cần tránh chỉ tính phí API. |
| Tỷ lệ lỗi nghiêm trọng | Lỗi thuộc nhóm tác động cao ÷ tổng nhiệm vụ được kiểm tra. | Lỗi hiếm nhưng nặng cần được báo riêng, không làm mờ trong tỷ lệ trung bình. |
Định nghĩa chỉ số rõ ràng
Mỗi KPI cần tên, công thức, đơn vị, mẫu số, phạm vi, nguồn log, tần suất và người sở hữu. Ví dụ “tỷ lệ hoàn thành” có thể được tính theo số phiên chat, số việc, số yêu cầu đã được agent nhận hay số yêu cầu đủ điều kiện. Các cách tính đó cho ra kết quả khác nhau. Tài liệu đánh giá phải nói rõ loại nào được đưa vào và vì sao.
Mỗi KPI nên lưu thuộc tính để người khác tái tạo phép đo:
- Nhiệm vụ đủ điều kiện: việc nào được đưa vào mẫu số.
- Tử số/mẫu số: sự kiện nào được xem là đạt, hoàn tất hoặc lỗi.
- Tiêu chí: rubric, ngưỡng và ngoại lệ.
- Nguồn: event/log hoặc dữ liệu review đã phân quyền.
- Phiên bản: model, prompt, nguồn và cấu hình liên quan.
- Thời gian/người phụ trách: chu kỳ tính, owner và nơi báo sự cố.
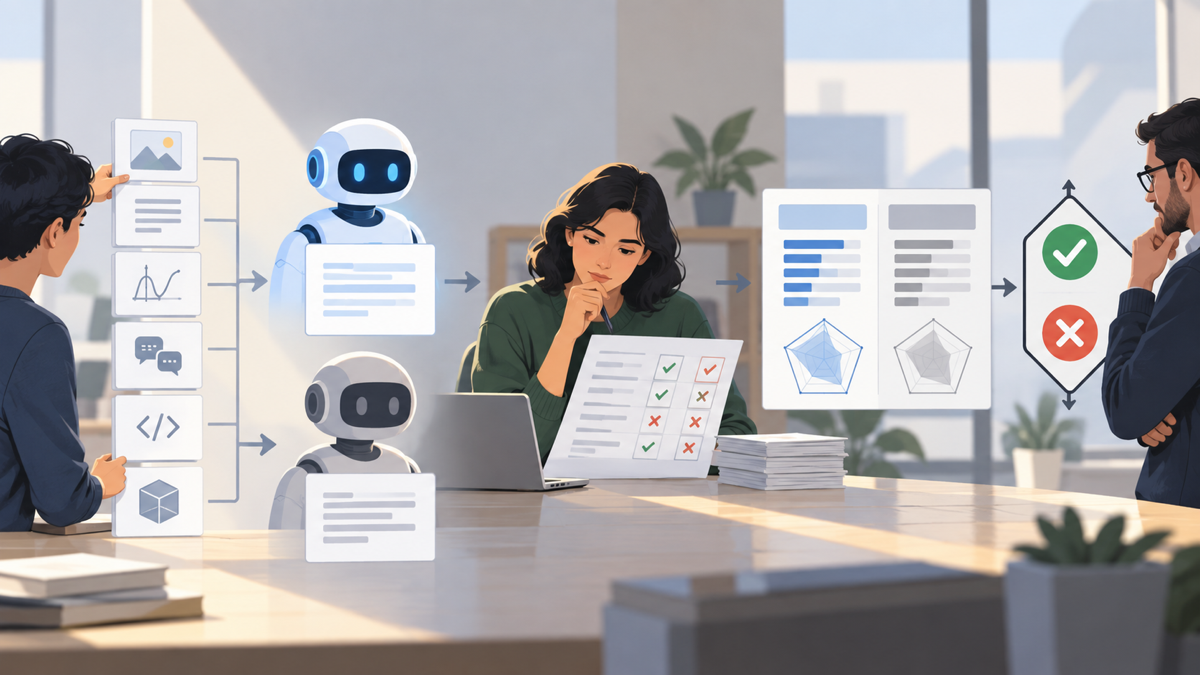
Rubric chất lượng nên mô tả quan sát được. Với trợ lý tra cứu, các câu hỏi có thể là: câu trả lời có bám chính sách hiện hành không; trích dẫn có mở tới đúng đoạn không; thiếu dữ kiện có được nêu rõ không; thông tin ngoài phạm vi có bị từ chối hoặc chuyển người không. Người chấm cần hướng dẫn và ví dụ để hai người có thể đánh giá tương tự, đồng thời ghi lại bất đồng thay vì ép đồng thuận.
Chia lỗi theo mức độ giúp ưu tiên. Lỗi định dạng có thể tốn thời gian sửa nhưng khác với lộ dữ liệu, tự ý thực hiện hành động, tư vấn sai ở tình huống quan trọng hay từ chối nhầm yêu cầu hợp lệ. Mức độ nên dựa trên ảnh hưởng và khả năng khắc phục trong chính quy trình; cần có người nghiệp vụ, bảo mật hoặc vận hành tham gia định nghĩa nhóm lỗi liên quan.
Ví dụ đánh giá một agent
Giả sử nhóm thử trợ lý trả lời câu hỏi nội bộ từ cẩm nang chính sách. Họ chuẩn bị 200 câu hỏi đại diện, trong đó có câu trả lời nằm trong tài liệu, câu thiếu thông tin, câu có nguồn mâu thuẫn và câu nằm ngoài phạm vi. Chuyên viên đánh dấu câu trả lời tham chiếu, nguồn cần trích dẫn và điều kiện phải chuyển người. Đây là tập đánh giá của thử nghiệm, không tự đại diện cho mọi truy vấn trong tương lai.
Mỗi câu hỏi được chấm theo bốn khía cạnh: đúng nội dung, nguồn hỗ trợ, nêu giới hạn khi thiếu dữ kiện và hành vi chuyển người. Bên cạnh đó, nhóm đo thời gian từ lúc nhập câu hỏi tới câu trả lời, thời gian nhân viên kiểm tra và số lần phải sửa. Một đầu ra trả lời nhanh nhưng cần chuyên viên tra cứu lại từ đầu nên không được xem như đã tiết kiệm toàn bộ thời gian.
Để có baseline, lấy cùng tập câu hỏi cho quy trình cũ hoặc cho nhân viên xử lý theo cách đang vận hành. So sánh chất lượng trên cùng tiêu chí; ghi bối cảnh và ai trả lời vì độ khó từng câu khác nhau. Nếu agent thay đổi model hoặc nguồn tài liệu giữa các lần chạy, lưu phiên bản cấu hình để kết quả không bị gộp thành một con số khó giải thích.
Báo cáo thử nghiệm nên đưa cả trung bình và trường hợp đáng chú ý: chủ đề nào agent làm tốt, nhóm câu hỏi nào thường sai, điều kiện nào cần escalation và loại sửa nào tiêu tốn thời gian. Với lỗi tác động lớn, một ví dụ có phân tích nguyên nhân quan trọng hơn việc chỉ thông báo rằng điểm tổng giảm một phần nhỏ.
Điều kiện để so sánh công bằng
So sánh trước và sau chỉ hữu ích nếu nhiệm vụ, mẫu, tiêu chí và cách tính tương đương. Nếu tháng đầu có nhiều câu hỏi đơn giản còn tháng sau có nhiều ngoại lệ, tỷ lệ hoàn thành không thể được diễn giải như thay đổi thuần túy về chất lượng. Có thể chia kết quả theo nhóm độ khó, kênh, ngôn ngữ hoặc mức rủi ro nếu các nhóm đủ dữ liệu và việc chia không làm lộ thông tin cá nhân.
- Nếu chưa có baseline, chạy thử song song hoặc lấy mẫu quy trình hiện tại trước khi tuyên bố tiết kiệm.
- Nếu tập đánh giá nhỏ, báo kèm số lượng trường hợp và tránh diễn giải khác biệt nhỏ như xu hướng chắc chắn.
- Nếu model, prompt, nguồn, quyền hoặc rubric thay đổi, đánh dấu phiên bản mới và chạy lại tập kiểm tra trọng yếu.
- Nếu có lỗi an toàn nghiêm trọng, báo riêng và điều tra nguyên nhân; không chờ chu kỳ KPI định kỳ.
- Nếu người dùng sửa đầu ra nhiều, ghi loại sửa và thời gian thay vì chỉ tính agent đã tạo câu trả lời.
Hướng dẫn của NIST về rủi ro AI tạo sinh khuyến khích tổ chức đánh giá theo bối cảnh sử dụng và trong suốt vòng đời. Đây không phải công thức KPI bắt buộc; nó nhắc rằng kết quả đo cần gắn với mục đích, người bị ảnh hưởng, cách sử dụng và cách hệ thống được theo dõi sau triển khai.
Sai lầm khi đo
- Chỉ đếm lượt tương tác: lượt chat có thể tăng vì agent hữu ích hoặc vì người dùng phải hỏi lại. Cần kiểm tra mức hoàn thành và công sức giải quyết.
- Chỉ báo cáo trung bình: mức trung bình che nhóm tình huống có lỗi cao hoặc nhóm người dùng bị ảnh hưởng nhiều hơn.
- Gộp lỗi nhỏ với lỗi lớn: tỉ lệ tổng không cho thấy một lỗi quyền riêng tư hay hành động sai có mức độ khác lỗi định dạng.
- Không tính công review: agent tạo đầu ra nhanh nhưng người duyệt mất nhiều thời gian thì hiệu quả ròng có thể thấp.
- Chọn KPI sau khi xem kết quả: dễ tạo cảm giác thành công bằng cách chỉ giữ chỉ số thuận lợi. Chốt định nghĩa và ngưỡng cần điều tra trước khi chạy.
- Coi một lần thử là bằng chứng đủ: thay đổi nguồn, model, tải hoặc hành vi người dùng có thể làm kết quả khác; cần theo dõi khi vận hành.
Kế hoạch đo thử nghiệm
- Chọn một nhiệm vụ và viết tiêu chí hoàn thành bằng hành vi quan sát được.
- Tạo tập tình huống đại diện, gồm trường hợp bình thường, thiếu dữ liệu, ngoại lệ và ngoài phạm vi.
- Chốt rubric, định nghĩa KPI, mẫu số, nguồn log và nhóm lỗi nghiêm trọng.
- Đo quy trình hiện tại để có baseline về chất lượng, thời gian và nhân lực.
- Chạy agent với giới hạn người dùng/quyền, thu dữ liệu cần thiết và lấy mẫu review.
- Phân tích kết quả theo nhóm; ghi rõ cỡ mẫu, phiên bản, bất định và sự cố.
- Quyết định mở rộng, điều chỉnh hay dừng dựa trên ngưỡng đã thống nhất trước.
Nếu đang thiết kế quy trình có điểm chuyển người, bài Human in the Loop trong AI Agent giúp làm rõ vai trò người duyệt. Với cách xây dựng tập kiểm tra và rubric cho LLM, xem hướng dẫn đánh giá ứng dụng LLM.
Nguồn tham khảo
- NIST: AI Risk Management Framework Generative AI Profile
- Microsoft Learn: Reduce autonomous agentic AI risk
KPI trong bài là ví dụ để thiết kế thử nghiệm, không phải chuẩn chung cho mọi sản phẩm. Ngưỡng chất lượng và cách lưu log cần do nhóm chịu trách nhiệm xác định theo bối cảnh.
Câu hỏi thường gặp
Tỷ lệ hoàn thành có nên là KPI chính?
Chỉ nên dùng cùng định nghĩa chất lượng và các nhóm lỗi. Tỷ lệ hoàn thành cao nhưng đầu ra không đúng, cần sửa nhiều hoặc không chuyển đúng ca rủi ro sẽ gây hiểu nhầm. Báo riêng hoàn tất tự động, hoàn tất sau chỉnh sửa và hoàn tất sau người xử lý.
Đo chất lượng khi chưa có đáp án chuẩn thế nào?
Xây rubric với chuyên gia nghiệp vụ, dùng mẫu câu hỏi thật đã được phép xử lý và có nhiều người chấm một phần mẫu để phát hiện tiêu chí mơ hồ. Với câu hỏi mở, tiêu chí có thể gồm đúng nguồn, đầy đủ điểm chính, nêu giới hạn và hành vi an toàn thay vì một đáp án nguyên văn.
Làm sao đo tỷ lệ chuyển người?
Định nghĩa trước trường hợp bắt buộc chuyển. Sau đó đo cả tỷ lệ chuyển đúng trên các ca cần chuyển lẫn tỷ lệ chuyển thừa trên ca có thể xử lý an toàn. Chỉ nhìn số chuyển tổng sẽ không cho biết agent thận trọng hợp lý hay đẩy quá nhiều việc sang nhân viên.
Có thể so KPI giữa hai model không?
Có thể nếu cùng tác vụ, tập đánh giá, nguồn, tiêu chí và điều kiện chạy. Ghi phiên bản, độ trễ và chi phí trong cùng phạm vi. Nếu model thay đổi hành vi hoặc định dạng, xem lỗi theo từng loại chứ không chỉ xếp hạng bằng một điểm tổng.
Chi phí trên mỗi nhiệm vụ nên gồm gì?
Tùy câu hỏi quản trị, có thể gồm phí model/API, hạ tầng, lưu trữ, giám sát, đánh giá và thời gian con người rà soát/sửa. Hãy công bố phạm vi tính. Nếu chỉ tính phí gọi model, gọi đó là chi phí model thay vì tổng chi phí vận hành.
Đo thời gian tiết kiệm ra sao?
So sánh thời gian hoàn tất cùng loại nhiệm vụ ở quy trình cũ và mới. Cộng thời gian người dùng nhập yêu cầu, đọc kết quả, sửa, duyệt, xử lý lỗi và chuyển tiếp. Có thể báo median hoặc phân bố nếu vài trường hợp kéo dài làm sai lệch trung bình.

Bình luận (0
)