AI có thể làm sạch, phân loại, tóm tắt phản hồi khách hàng để tìm chủ đề cần xem xét. Giữ bằng chứng truy xuất, kiểm tra kết quả trên mẫu con người xác nhận và bảo vệ dữ liệu cá nhân. Insight chỉ mô tả tập phản hồi thu thập, không đại diện toàn bộ khách hàng.
Bắt đầu từ câu hỏi, không phải từ mô hình
Phân tích phản hồi bằng AI thường có thể bao gồm chuẩn hóa định dạng, phát hiện bản ghi trùng, phân nhóm chủ đề, gợi ý sắc thái, trích câu minh họa và tổng hợp câu hỏi mở. Mỗi tác vụ có giới hạn riêng. Mô hình có thể gán nhãn sai khi bình luận mỉa mai, thiếu ngữ cảnh, dùng tiếng lóng hoặc trộn nhiều chủ đề trong một câu. Vì vậy, kết quả nên giữ được liên kết tới phản hồi gốc đã được phép sử dụng.
Thuộc tính dữ liệu phản hồi
Trước khi yêu cầu mô hình phân tích, hãy tạo một bộ dữ liệu có nguồn gốc và ngữ cảnh. Một số trường cần thiết tùy câu hỏi; không phải cột nào có trong CRM cũng nên được dùng. Mỗi thuộc tính cần có định nghĩa để nhà phân tích, chuyên viên chăm sóc khách hàng và nhóm sản phẩm hiểu nhất quán.
- Nội dung: văn bản khách hàng đã gửi, giữ nguyên ý và dấu câu hữu ích; chỉ chuẩn hóa khoảng trắng hoặc mã hóa ký tự, không sửa lời phản hồi để “dễ đọc” hơn.
- Kênh và thời điểm: khảo sát sau giao dịch, email hỗ trợ, đánh giá công khai hay phỏng vấn; lưu múi giờ và giai đoạn chiến dịch nếu có.
- Ngữ cảnh dịch vụ: loại sản phẩm, phiên bản ứng dụng, bước trong hành trình hoặc nhóm yêu cầu; chỉ lấy các trường phục vụ câu hỏi phân tích.
- Mã bản ghi: mã giả danh để nối phản hồi với cùng một vụ việc khi cần, tránh lặp dữ liệu và không chứa email, số điện thoại hoặc tên hiển thị.
- Nhãn và định nghĩa: chủ đề, loại vấn đề, sắc thái hoặc mức ưu tiên; có mô tả và ví dụ ranh giới để người gán nhãn hiểu giống nhau.
- Bằng chứng: đoạn trích ngắn, mã bản ghi, kênh và khoảng thời gian; đây là đường quay lại dữ liệu để xác minh kết luận.
- Trạng thái chưa chắc chắn: thiếu ngữ cảnh, đa chủ đề, câu đùa, ngôn ngữ pha trộn hoặc nhãn ngoài danh mục.
| Loại dữ liệu | Câu hỏi kiểm tra | Xử lý phù hợp |
|---|---|---|
| Thông tin nhận diện | Có thực sự cần biết tên, email hoặc số đơn để trả lời câu hỏi phân tích không? | Loại bỏ hoặc thay bằng mã giả danh trước khi dùng; giới hạn quyền truy cập bảng nối. |
| Phản hồi lặp | Là bản gửi trùng, nhiều cập nhật cho một vụ việc hay hai ý kiến riêng? | Đặt quy tắc khử trùng và giữ dấu vết quyết định; không xóa bản ghi chỉ vì cùng nội dung. |
| Ngữ cảnh thiếu | Có biết sản phẩm, thời điểm và bước người dùng đang gặp vấn đề không? | Gắn trạng thái thiếu; tránh kết luận nguyên nhân khi không có ngữ cảnh. |
| Đa ngôn ngữ | Nhãn và quy tắc có áp dụng nhất quán cho tiếng Việt, tiếng Anh, từ viết tắt? | Lấy mẫu theo ngôn ngữ, giữ nguyên trích dẫn và yêu cầu người hiểu ngôn ngữ kiểm tra. |
| Dữ liệu nhạy cảm | Nội dung có chứa thông tin tài khoản, sức khỏe, thanh toán hay dữ liệu nội bộ? | Áp dụng chính sách phân loại, giảm thiểu dữ liệu và chỉ dùng công cụ đã được tổ chức cho phép. |
Quy trình phân tích có thể kiểm tra
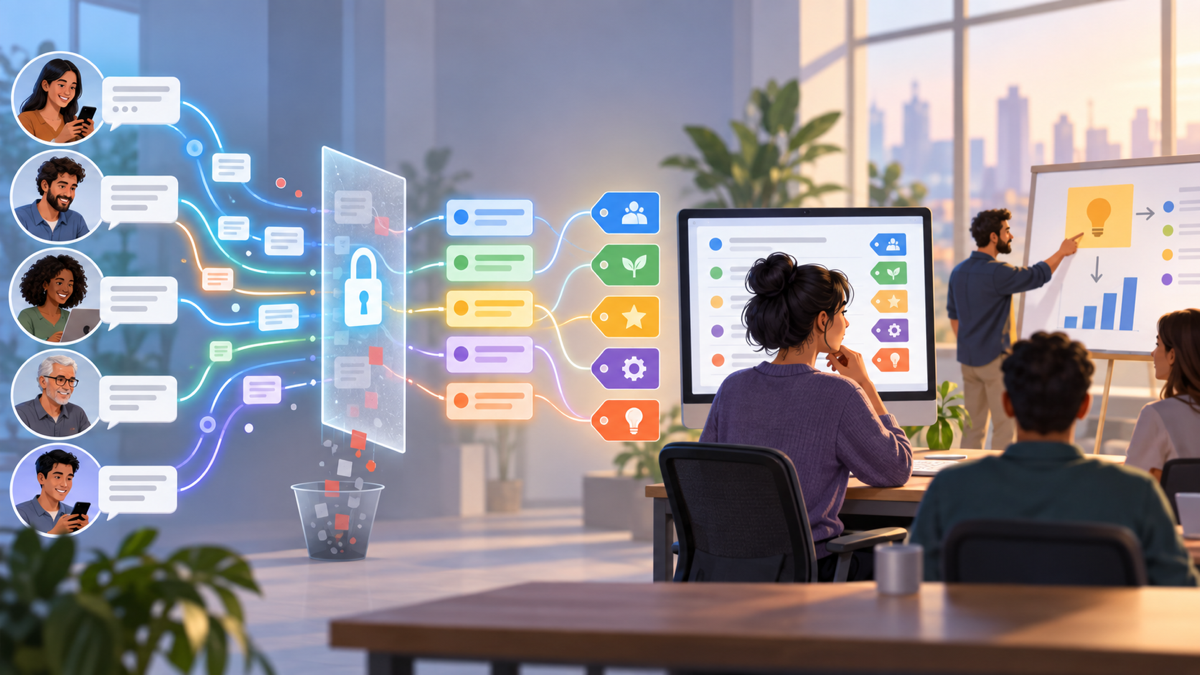
- Chốt câu hỏi và phạm vi. Ghi rõ nhóm khách hàng, kênh, thời gian, sản phẩm và quyết định sẽ được hỗ trợ. Nếu mục tiêu là tìm vấn đề sau khi phát hành phiên bản mới, cần đánh dấu thời điểm phát hành và nhóm so sánh phù hợp.
- Kiểm tra quyền và chất lượng dữ liệu. Xác định ai sở hữu nguồn, mục đích sử dụng, trường nào nhạy cảm và công cụ nào được phép xử lý. Đếm bản ghi, kiểm tra encoding, tệp rỗng, trùng lặp, ngôn ngữ và tỷ lệ thiếu ngữ cảnh trước khi gọi model.
- Định nghĩa taxonomy. Bắt đầu bằng một bộ nhãn đủ nhỏ để phân biệt các vấn đề cần hành động. Mỗi nhãn có tên, định nghĩa, ví dụ bao gồm, ví dụ không bao gồm và quy tắc gán khi một phản hồi chạm nhiều chủ đề.
- Kiểm tra thủ công một mẫu. Người hiểu sản phẩm đọc mẫu phân tầng theo kênh, thời gian và ngôn ngữ để tìm chủ đề chưa có. Mẫu dùng để kiểm tra không chỉ nên lấy từ những phản hồi dài hoặc rõ ràng.
- Chạy phân loại trên lô nhỏ. Lưu phiên bản prompt, model, taxonomy và cấu hình. Yêu cầu mô hình xuất nhãn, câu dẫn chứng và trạng thái cần người xem; kiểm tra output schema trước khi nhập vào bảng phân tích.
- Đo sai số theo từng nhãn. Lấy mẫu kết quả đã gán và so với nhãn do con người xác nhận. Đặc biệt kiểm tra các nhãn ít dữ liệu, các cặp hay nhầm và nhóm dễ gây hậu quả nếu bị bỏ sót.
- Đọc phản hồi gốc trước khi kết luận. Với nhóm lớn hoặc bất ngờ, mở mẫu câu thực tế để xem chúng có cùng một nguyên nhân hay chỉ giống từ khóa. Trích dẫn minh họa cần ẩn danh, đủ ngữ cảnh và không làm lộ danh tính.
- Viết insight có giới hạn. Nêu dữ liệu đến từ đâu, số lượng bản ghi nào được xem, điều gì lặp lại, ví dụ nào hỗ trợ nhận định và phần gì chưa thể kết luận. Giao quyết định tiếp theo cho chủ sở hữu sản phẩm hoặc dịch vụ.
Ví dụ và prompt thực hành
Taxonomy có thể gồm “không hoàn tất thanh toán”, “không hiểu phí”, “phương thức không hỗ trợ”, “yêu cầu hoàn tiền” và “ngoài phạm vi”. Định nghĩa rõ để câu hỏi về thời điểm trừ tiền không bị nhầm thành lỗi thanh toán. Thử trên mẫu nhỏ, đọc lại ca “ngoài phạm vi” và quyết định trước có cho phép nhiều nhãn hay không.
Prompt dưới đây yêu cầu mô hình trả đầu ra có căn cứ. Không đưa dữ liệu thật vào công cụ khi quyền sử dụng chưa được xác nhận; thử nghiệm prompt nên dùng dữ liệu đã được phép và đã giảm thiểu định danh.
Phân loại phản hồi đã ẩn danh theo danh mục nhãn bên dưới. Trả về mã phản hồi, tối đa hai nhãn, đoạn trích ngắn làm bằng chứng, lý do chọn nhãn và trạng thái “cần người xem” nếu thiếu ngữ cảnh, mỉa mai, đa chủ đề hoặc nằm ngoài danh mục. Chỉ dùng nội dung của phản hồi; không suy đoán danh tính, động cơ hay nguyên nhân kỹ thuật. Nếu không có bằng chứng rõ, trả nhãn “chưa xác định”. Giữ nguyên ngôn ngữ của trích dẫn. Danh mục và định nghĩa nhãn: [dán taxonomy đã được nhóm duyệt].
Nhóm có thể xem ví dụ sai theo từng loại: phản hồi nhắc “đắt” nhưng khen giá hợp lý; câu “tuyệt quá” mang ý châm biếm; một đoạn vừa báo lỗi đăng nhập vừa góp ý giao diện; bản ghi chỉ ghi “không chạy” mà thiếu thiết bị hoặc thao tác. Những ca này cho biết cần sửa định nghĩa taxonomy, bổ sung lựa chọn “không xác định”, hay cần chia dữ liệu theo ngữ cảnh. Không nên tăng số nhãn chỉ để ép mọi trường hợp vào một loại.
Điều kiện để diễn giải kết quả
Kết quả phân loại trả lời “trong tập văn bản đã phân tích, mô hình gán nhãn gì?”, không tự trả lời “bao nhiêu phần trăm khách hàng có vấn đề?” Muốn ước lượng mức phổ biến cần biết cách chọn mẫu, tỷ lệ phản hồi, nhóm không trả lời, số người duy nhất và định nghĩa mẫu số. Không có những yếu tố đó, nên diễn đạt là “trong các phản hồi nhận được” thay vì khái quát sang toàn bộ khách hàng.
- Nếu mục đích là tìm vấn đề mới, dùng phân nhóm gợi ý rồi để chuyên viên đọc ví dụ và đặt tên chủ đề.
- Nếu cần theo dõi nhãn qua thời gian, giữ taxonomy ổn định, ghi phiên bản và kiểm tra lại mẫu khi thay đổi prompt/model.
- Nếu kết quả dùng để quyết định ưu tiên sản phẩm, ghép số lượng với mức nghiêm trọng, hành trình bị ảnh hưởng và bằng chứng gốc.
- Nếu phản hồi liên quan khiếu nại cá nhân, hoàn tiền, sức khỏe, dữ liệu tài chính hoặc tranh chấp, chuyển theo quy trình hỗ trợ phù hợp; không để phân loại tự động thay quyết định xử lý.
- Nếu mẫu nhỏ hoặc lệch mạnh về một kênh/ngôn ngữ, nêu giới hạn rõ và không so sánh nhóm như thể cách thu thập tương đương.
Sai lệch cần lưu ý
- Chỉ lấy phản hồi tiêu cực: dễ tạo ấn tượng vấn đề phổ biến hơn thực tế. Cần nêu tiêu chí lọc và lưu cả phản hồi tích cực, trung tính nếu câu hỏi cần bức tranh đầy đủ.
- Để từ khóa quyết định nhãn: từ “hoàn tiền” có thể là câu hỏi quy trình hoặc khiếu nại. Đọc ngữ cảnh câu và lượt trước sau nếu được phép.
- Gộp nhiều vấn đề thành một nhãn: làm báo cáo khó chỉ ra biện pháp. Cho phép đa nhãn khi taxonomy định nghĩa rõ; giữ bằng chứng riêng cho từng nhãn.
- Dùng “sắc thái” như sự thật khách quan: phân loại cảm xúc là nhận định mô hình, dễ bị ảnh hưởng bởi mỉa mai, văn hóa, ngôn ngữ và cách viết ngắn.
Hãy giữ một tập kiểm tra do con người gán nhãn, có ví dụ rõ và ca khó. Khi thay đổi danh mục hoặc cấu hình, chạy lại tập đó để xem nhãn nào cải thiện hay suy giảm. Tập kiểm tra cần được cập nhật định kỳ để phản ánh cách khách hàng nói chuyện mới, nhưng nên giữ riêng một phần ổn định để nhìn xu hướng qua các phiên bản.
Checklist áp dụng
- Viết câu hỏi phân tích và quyết định mà kết quả sẽ hỗ trợ.
- Xác nhận quyền sử dụng dữ liệu, công cụ xử lý và trường cần loại bỏ/ẩn danh.
- Thống nhất đơn vị phân tích, quy tắc khử trùng và thời gian lấy mẫu.
- Tạo taxonomy có định nghĩa, ví dụ và nhãn chưa xác định.
- Thử trên mẫu đại diện; đo chất lượng theo từng nhãn và ngôn ngữ.
- Giữ bằng chứng truy xuất, ghi phiên bản cấu hình và giới hạn diễn giải.
- Yêu cầu chủ sản phẩm hoặc dịch vụ xác nhận insight trước khi hành động.
AI có thể giảm thời gian sắp xếp phản hồi, nhưng giá trị nằm ở khả năng giúp nhóm nhìn ra vấn đề có thể kiểm chứng. Để phân biệt ý tưởng ứng dụng AI cho marketing với một quy trình phân tích có đánh giá chất lượng, xem các ví dụ AI hỗ trợ marketing và cách đánh giá ứng dụng LLM.
Nguồn tham khảo
Bài viết hướng dẫn cách tổ chức phân tích ở mức khái quát. Cách xử lý dữ liệu phản hồi phải theo chính sách dữ liệu và quyền riêng tư áp dụng tại tổ chức.
Câu hỏi thường gặp
AI có thể xác định chính xác cảm xúc của mọi phản hồi không?
Không nên giả định như vậy. Mỉa mai, thành ngữ, câu rất ngắn, pha ngôn ngữ hoặc thiếu hội thoại trước đó có thể làm mô hình hiểu sai. Nếu cần dùng nhãn sắc thái, hãy định nghĩa rõ mục đích, kiểm tra theo ngôn ngữ/kênh và cho phép trạng thái chưa chắc chắn.
Có nên gửi nguyên văn phản hồi khách hàng cho mô hình?
Chỉ khi tổ chức đã xác nhận mục đích, quyền xử lý và công cụ được phép. Trước đó, rà soát thông tin nhận diện, mã đơn, nội dung thanh toán hoặc dữ liệu nhạy cảm; giảm thiểu hay ẩn danh trường không cần thiết và không tải lên dịch vụ chưa được duyệt.
Làm sao biết nhãn AI gán có đáng tin?
Lấy mẫu có đại diện cho chủ đề, kênh và ngôn ngữ rồi so với gán nhãn của người hiểu nghiệp vụ. Tính sai số theo từng nhãn, xem các cặp nhầm lẫn và cập nhật taxonomy. Một con số độ chính xác chung có thể che lỗi ở nhãn ít xuất hiện.
Có thể dùng số lượt nhắc để ưu tiên sửa sản phẩm không?
Số lượt trong tập đã thu thập là một tín hiệu, không phải tiêu chí duy nhất. Cần xem mức ảnh hưởng, mức độ nghiêm trọng, số người duy nhất, tỷ lệ phản hồi và khả năng kiểm chứng. Nếu mẫu thiên về một kênh, nêu giới hạn trước khi so sánh.
Nên xử lý phản hồi có nhiều vấn đề thế nào?
Quyết định trước taxonomy có cho phép nhiều nhãn hay không. Nếu có, gắn từng nhãn với một bằng chứng riêng để người đọc biết câu nào hỗ trợ nhận định nào. Nếu không thể tách, dùng nhãn “đa chủ đề/cần người xem” thay vì ép vào nhóm gần nhất.
Khi nào chuyên viên cần kiểm tra thủ công?
Kiểm tra thủ công khi dựng taxonomy, khi nhãn mới xuất hiện, khi kết quả mâu thuẫn với dữ liệu vận hành, hoặc khi quyết định ảnh hưởng trực tiếp tới một khách hàng. Cũng cần rà soát mẫu định kỳ sau khi thay model, prompt, nguồn hoặc cách thu thập dữ liệu.

Bình luận (0
)