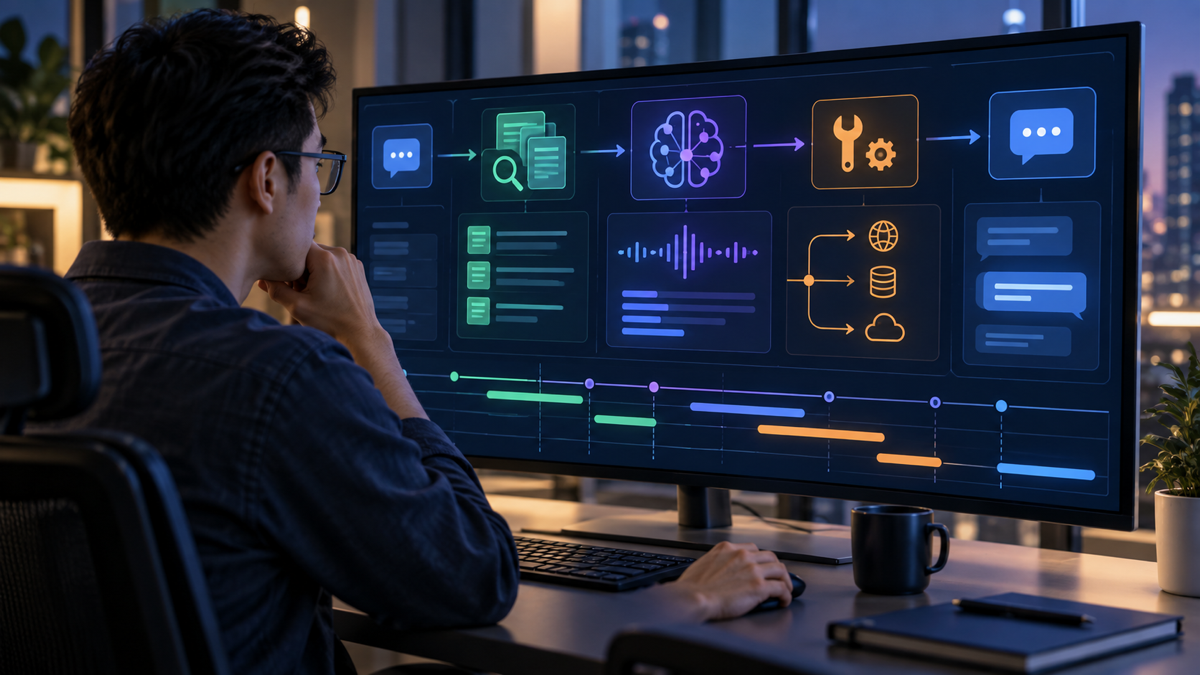
LLM observability giúp theo dõi ứng dụng dùng mô hình ngôn ngữ qua trace, log, metric, phiên bản prompt, nguồn truy xuất, lỗi và độ trễ. Nó hỗ trợ tìm nguyên nhân sự cố. Để đánh giá chất lượng, cần kết hợp telemetry với eval và phản hồi người dùng.
LLM observability là gì?
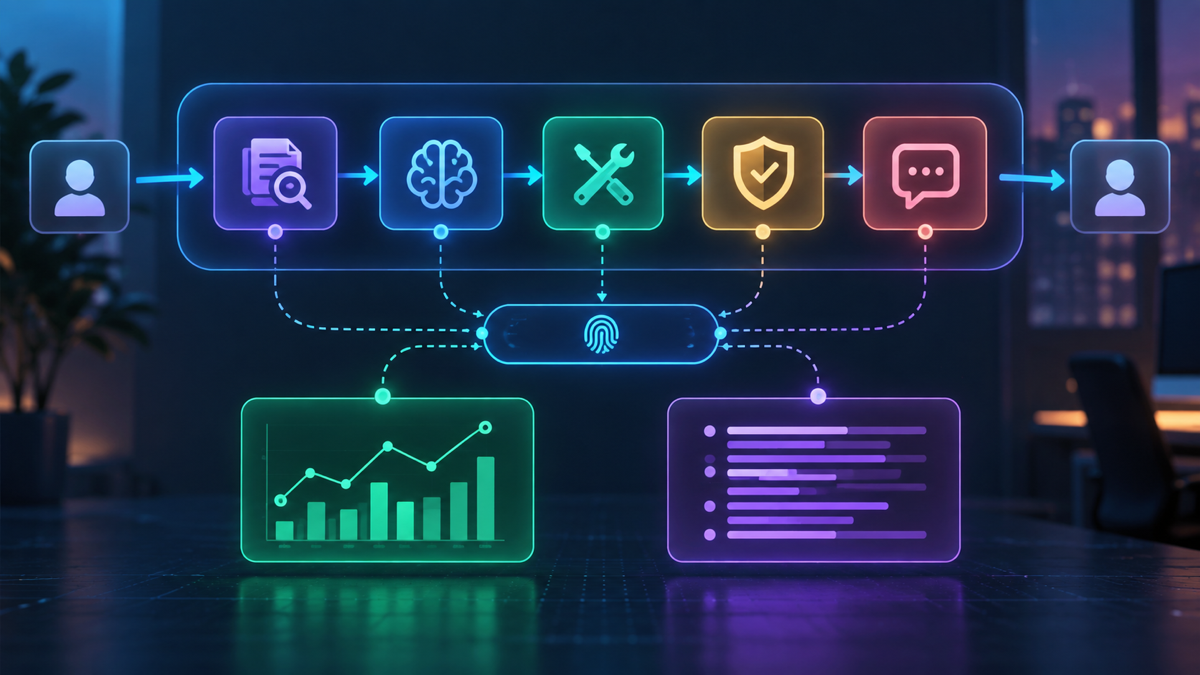
Observability là khả năng hiểu trạng thái bên trong hệ thống từ tín hiệu mà hệ thống phát ra. OpenTelemetry mô tả các tín hiệu phổ biến gồm trace, metric và log. Với ứng dụng LLM, mỗi lần gọi model thường nằm trong một chuỗi bước: nhận request, lấy dữ liệu, dựng prompt, gọi model, parse kết quả, gọi công cụ và trả lời. Nếu chỉ lưu câu trả lời cuối, đội vận hành khó biết bước nào gây ra lỗi.
LLM observability mở rộng telemetry vận hành bằng ngữ cảnh liên quan tới model và pipeline: tên/version model, phiên bản prompt, thời gian từng bước, lỗi provider, mức token, nguồn retrieval, kết quả tool và trạng thái kiểm tra đầu ra. Những thuộc tính giúp phân biệt “model chậm” với “retriever trả quá nhiều context” hoặc “tool timeout”. Cách instrument cụ thể tùy kiến trúc; nên dùng schema ổn định và hạn chế lưu nội dung nhạy cảm.
Observability không đồng nghĩa với một dashboard hoặc một sản phẩm trả phí. Đó là khả năng đặt câu hỏi mới từ telemetry đã thiết kế. Một dashboard có hàng chục biểu đồ vẫn thiếu observability nếu không liên kết request, phiên bản và lỗi. Ngược lại, trace có cấu trúc, vài metric phù hợp và log được bảo vệ có thể đủ để giải quyết nhiều sự cố.
Trace, span, log và metric
- Trace: đường đi của một request qua các dịch vụ và thao tác. Trace ID giúp nhóm log và bước cùng một lần xử lý.
- Span: một đơn vị công việc trong trace, có thời gian bắt đầu/kết thúc, trạng thái và thuộc tính; ví dụ “retrieval”, “model call” hay “tool execution”.
- Log: thông điệp theo thời gian ghi một sự kiện hoặc lỗi. Log hữu ích hơn khi gắn trace/span ID để xem trong đúng ngữ cảnh.
- Metric: số đo tổng hợp qua thời gian như request/giây, tỷ lệ lỗi, p95 latency hoặc token/request. Metric giúp nhìn xu hướng, nhưng không tự cho biết nội dung cụ thể gây lỗi.
- Event: sự kiện có thời điểm trong span, như retry hoặc bước fallback; dùng khi cần chỉ ra việc xảy ra trong một hoạt động.
Đừng để trace chứa toàn bộ cuộc hội thoại theo mặc định. Thay vào đó ghi kích thước context, ID nguồn đã phân quyền, checksum/version hoặc thuộc tính đủ để tái hiện vấn đề khi được phép. Nếu nội dung prompt phải lưu để debug, áp dụng redaction, encryption, access control, retention và quy trình xóa tương ứng.
Thuộc tính cần theo dõi trong LLM application
- Request: trace ID, loại tác vụ, môi trường, thời điểm, tenant/account đã giả danh và phiên bản ứng dụng.
- Model invocation: nhà cung cấp, model ID/version nếu có, timeout, status, retry, input/output token hoặc đơn vị mà provider trả.
- Prompt: template ID/version, loại message, kích thước, cache hit nếu sử dụng; nội dung thô chỉ khi có nhu cầu và được phép.
- Retrieval: query ID, kho/index và phiên bản, số tài liệu lấy, score range, thời gian, trạng thái ACL; tránh ghi đầy đủ nội dung tài liệu nhạy cảm.
- Tool: tên tool, validation result, quyền được cấp, thời gian thực hiện, mã lỗi và có cần approval hay không.
- Output: parse/schema status, policy check, citation check, độ dài và feedback; đừng suy ra chất lượng chỉ từ độ tự tin do model tự báo.
- Cost/latency: token hoặc chi phí provider trả, thời gian từng span, thời gian end-to-end và số lần retry.
Tránh đưa giá trị duy nhất cho mỗi user, prompt hoặc tài liệu thành nhãn metric vì điều đó tạo cardinality rất cao và có thể lộ thông tin. Dùng ID đã giả danh trong trace hoặc log có kiểm soát; tổng hợp metric theo model, tác vụ, phiên bản và trạng thái. Tách dữ liệu vận hành khỏi dữ liệu ứng dụng để khi cần xóa hoặc giới hạn truy cập, đội biết nơi cần xử lý.
Bảng chỉ số và câu hỏi vận hành
| Nhóm | Ví dụ tín hiệu | Câu hỏi giúp trả lời | Điều metric không nói |
|---|---|---|---|
| Độ trễ | p50/p95 end-to-end và mỗi span | Chậm ở retrieval, model, tool hay mạng? | Phản hồi nhanh có đúng/hữu ích không? |
| Lỗi/tính sẵn sàng | HTTP/status, timeout, retry, fallback | Tỷ lệ request thất bại tăng ở phiên bản nào? | Một response thành công có bám policy không? |
| Sử dụng/chi phí | Token input/output, request và retry theo tác vụ | Prompt/context nào tăng mức sử dụng? | Chi phí thấp có đạt chất lượng cần không? |
| Retrieval | Document IDs, số chunk, freshness, latency | Trợ lý lấy nguồn nào trước câu trả lời sai? | Đoạn được lấy có đúng nghĩa và đủ căn cứ? |
| Chất lượng | Eval score, citation pass, human feedback, correction | Chất lượng giảm sau đổi prompt/model ở đâu? | Điểm tự động có đại diện cho trải nghiệm thật? |
| An toàn/riêng tư | Policy block, access denial, redaction event | Có input hoặc hành động vượt phạm vi? | Không thấy sự cố trong log không chứng minh không có sự cố. |
Đặt cảnh báo theo baseline và mức độ tác động. Ví dụ: tăng timeout retrieval có thể cảnh báo kỹ thuật; giảm citation pass ở một intent có thể tạo ticket rà bộ dữ liệu; truy cập ACL bị từ chối hàng loạt có thể cần xem hành vi bất thường. Ngưỡng cần chọn theo ứng dụng và được thử để không báo động liên tục.
Ví dụ trace cho chatbot RAG
Người dùng hỏi về quy trình hoàn ứng. Trace có root span “chat request”, sau đó là auth, retrieval, prompt assembly, model call, output check và response. Các span ghi thời gian, phiên bản index/prompt/model, số nguồn được lấy, trạng thái ACL và kết quả kiểm tra trích dẫn. Nếu câu trả lời sai, đội có thể xem tài liệu cũ được retrieval chọn hay model bỏ qua nguồn.
Giả sử lỗi xảy ra sau khi tài liệu chính sách được cập nhật. Trace cho thấy index chưa ingest phiên bản mới, trong khi model call và latency bình thường. Nguyên nhân nằm ở pipeline cập nhật dữ liệu chứ không phải model. Đội có thể dừng câu trả lời cho chủ đề đó hoặc hiển thị thông báo chuyển HR cho đến khi index được cập nhật; sau đó thêm test xác nhận tài liệu đúng phiên bản được truy xuất.
Nếu trace lưu toàn bộ câu hỏi nhân viên và đoạn chính sách, chúng có thể chứa thông tin cá nhân hoặc nội bộ. Có thể thay nội dung bằng ID tài liệu, request fingerprint và trạng thái kiểm tra, rồi chỉ mở nội dung cho nhóm hỗ trợ có quyền trong khoảng thời gian giới hạn. Chỉ lưu thêm payload khi sự cố cần điều đó, có phê duyệt và phương án xóa.
Thiết kế instrumentation an toàn
- Chọn câu hỏi vận hành: cần điều tra chậm, sai nguồn, lỗi tool hay chi phí bất thường?
- Xác định span: lập cây thao tác ổn định và đặt trace context xuyên các service.
- Chọn thuộc tính: chỉ ghi thông tin cần để phân loại lỗi và tái hiện.
- Phân loại nhạy cảm: redaction trước khi xuất telemetry; bảo vệ trace backend như dữ liệu ứng dụng.
- Đặt sampling và retention: giữ đầy đủ sự kiện lỗi cần thiết, lấy mẫu hợp lý cho tải lớn và xóa theo policy.
- Kết nối alert với người sở hữu: mỗi cảnh báo có runbook, mức độ và cách rollback/escalate.
- Rà lại sau thay đổi: model, prompt, retrieval, tool, schema hoặc policy mới đều có thể làm tín hiệu cũ mất ý nghĩa.
OpenTelemetry là framework trung lập nhà cung cấp để instrument, tạo, thu thập và xuất traces, metrics, logs. Dùng chuẩn hoặc quy ước nhất quán có thể giúp kết nối nhiều thành phần mà không gắn telemetry với một dashboard cụ thể. Dù vậy, OTel không tự xác định dữ liệu nào an toàn lưu; việc thu thập và quyền truy cập vẫn do nhóm sản phẩm/bảo mật thiết kế.
Observability khác gì đánh giá chất lượng?
Observability giải thích điều đã xảy ra trong một request; evaluation ước lượng mức đáp ứng mục tiêu bằng tập case và rubric. Hai phần bổ sung cho nhau. Một trace có thể chỉ ra model được gửi prompt nào và lấy context gì; eval cho biết cách thay đổi prompt/index ảnh hưởng chất lượng trên nhóm tình huống. Feedback của người dùng giúp nhận ra tác vụ thật mà bộ test chưa bao phủ.
Với mỗi phiên bản, lưu bộ eval có tác vụ thường gặp, dữ liệu thiếu, nguồn xung đột, hành vi từ chối và prompt injection phù hợp ứng dụng. Đo độ bám nguồn, đúng ý, đủ trường, độ trễ và chi phí. Nếu dùng judge model, so kết quả của nó với đánh giá người trên mẫu và theo dõi sai lệch. OpenAI API có hướng dẫn Evals để xây quy trình đánh giá; không nên hiểu một metric đơn lẻ là chuẩn chung cho mọi ứng dụng.
Nếu latency/cost tốt nhưng eval an toàn giảm, không tối ưu chỉ tiêu vận hành bằng cách nới kiểm soát. Nếu eval ổn trong bộ kiểm tra nhưng phản hồi người dùng xấu, bổ sung tình huống hoặc làm rõ định nghĩa “tốt”. Quyết định release dựa trên rubric, impact, owner và phương án rollback.
Câu hỏi thường gặp
LLM observability khác APM thông thường thế nào?
APM tập trung theo dõi ứng dụng/hạ tầng; LLM observability bổ sung ngữ cảnh model, prompt, retrieval, tool và đánh giá đầu ra. Nền tảng trace/metric/log có thể dùng chung nếu schema đáp ứng nhu cầu.
Trace có cần lưu prompt và câu trả lời đầy đủ không?
Không mặc định. Nội dung có thể chứa dữ liệu cá nhân, bí mật hoặc prompt injection. Bắt đầu với ID, phiên bản, kích thước, trạng thái và nguồn; chỉ lưu payload khi có lý do, quyền và retention rõ.
Metric nào nên có đầu tiên?
Bắt đầu với tỷ lệ lỗi/timeout, p50/p95 end-to-end, latency theo span, retry và mức token/chi phí nếu có. Thêm metric chất lượng gắn với tác vụ, như citation pass hoặc tỷ lệ phải sửa.
Observability có đo hallucination được không?
Telemetry giúp tìm prompt/context và mẫu lỗi; tự nó không quyết định sự thật. Cần rubric, nguồn đối chiếu, tập eval và review người cho các trường hợp quan trọng.
Sampling có làm mất sự cố không?
Có thể bỏ một request hiếm. Kết hợp sampling với lưu full trace cho lỗi/trigger quan trọng, metric tổng hợp và cơ chế tăng mức ghi nhận khi điều tra; kiểm tra chi phí và quyền riêng tư.
Có cần một nền tảng LLM observability chuyên dụng?
Không bắt buộc. Chọn cách instrument theo quy mô, yêu cầu tích hợp, quyền dữ liệu và năng lực vận hành. Chuẩn hóa trace/context và schema trước để có thể thay đổi công cụ nếu cần.
Kết luận
LLM observability giúp lần theo request qua model, retrieval và tool để giải thích sự cố vận hành. Theo dõi trace, span, metric và log có kiểm soát; ghép telemetry với eval và phản hồi để đo chất lượng. Bắt đầu từ câu hỏi cần trả lời, chỉ lưu dữ liệu cần thiết và thiết lập owner cùng runbook cho cảnh báo.

Bình luận (0
)