Generative AI tạo nội dung như văn bản, mã, hình ảnh hoặc âm thanh theo đầu vào và mẫu đã học. Công cụ phù hợp để tạo bản nháp, biến đổi hoặc tổng hợp; kết quả vẫn cần kiểm tra độ đúng, quyền sử dụng và mức phù hợp với người dùng.
Generative AI có nghĩa là gì?
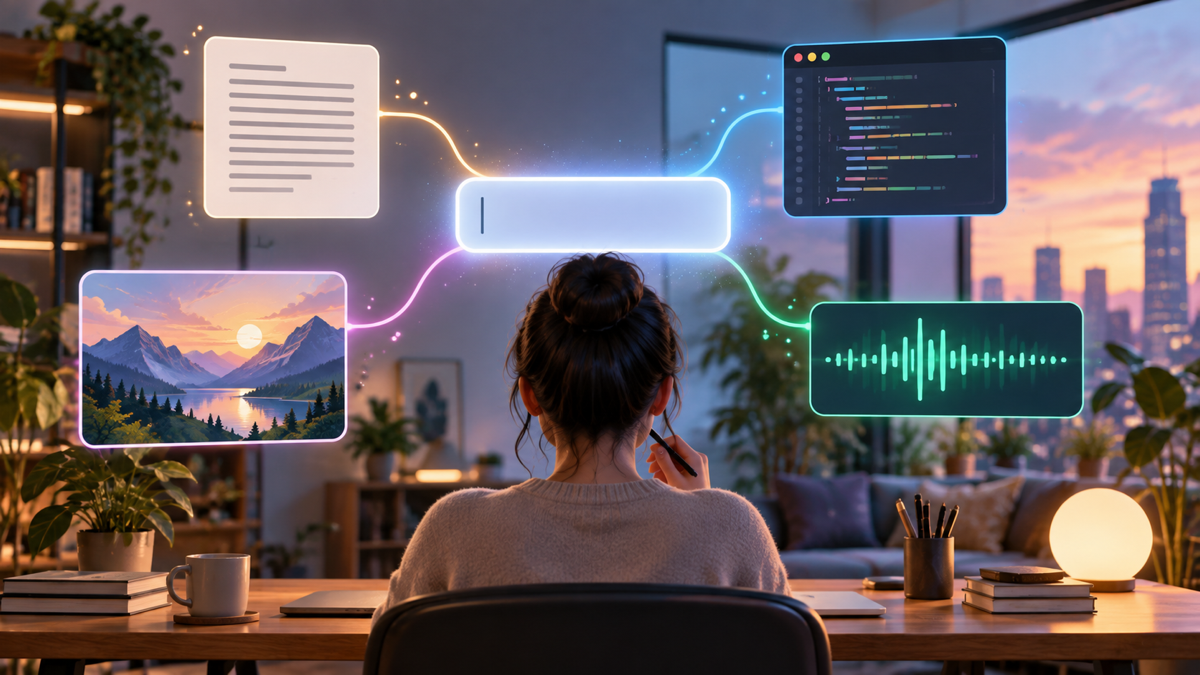
Generative AI, hay AI tạo sinh, là cách gọi các hệ thống học từ dữ liệu để tạo đầu ra mới theo yêu cầu. Google for Developers mô tả mô hình generative có thể tạo nhiều loại nội dung, còn NIST xem generative AI như một lớp công nghệ có rủi ro riêng cần được cân nhắc trong vòng đời hệ thống. Đầu ra có thể là câu trả lời, bản tóm tắt, đoạn mã, hình ảnh hoặc một chuỗi âm thanh, tùy mô hình và ứng dụng.
“Tạo nội dung mới” không có nghĩa hệ thống suy nghĩ như con người hoặc tự xác nhận nội dung đúng. Mô hình sinh tạo đầu ra dựa trên cấu trúc đã học và điều kiện đưa vào. Nó có thể tạo một câu nghe tự nhiên nhưng sai sự kiện, lặp thiên lệch trong dữ liệu, hoặc không hiểu mục tiêu thực tế phía sau câu hỏi. Vì vậy, cần tách khả năng tạo nội dung khỏi độ tin cậy và quyền sử dụng nội dung đó.
Generative AI là một họ phương pháp và ứng dụng, không phải một sản phẩm đơn lẻ. Chatbot, công cụ gợi ý mã, công cụ chuyển văn bản thành hình ảnh, hệ thống tạo giọng nói và công cụ tóm tắt tài liệu đều có thể dùng kỹ thuật tạo sinh, nhưng giao diện, model, dữ liệu và điều khoản khác nhau. Không nên suy từ một công cụ sang mọi hệ thống cùng nhãn.
Generative AI khác gì AI phân loại và dự đoán?
AI phân loại thường chọn nhãn trong tập đã định, như “yêu cầu hỗ trợ kỹ thuật” hay “yêu cầu thanh toán”. Mô hình dự đoán ước lượng một giá trị hoặc xác suất, như lượng hàng có thể bán trong một giai đoạn. AI tạo sinh xây dựng nội dung theo điều kiện, ví dụ soạn câu trả lời dựa trên chính sách hoặc chuyển ghi chú thành bản tóm tắt.
Ranh giới này không tuyệt đối. Một sản phẩm có thể kết hợp phân loại để định tuyến, truy xuất tài liệu để lấy nguồn và mô hình tạo sinh để viết câu trả lời. Đội phát triển nên mô tả hành vi cần đạt, không chỉ chọn loại model theo xu hướng. Nếu đầu ra mong muốn là một nhãn ổn định, mô hình phân loại hoặc quy tắc đơn giản có thể dễ kiểm tra hơn văn bản sinh tự do.
| Loại hệ thống | Đầu ra điển hình | Ví dụ câu hỏi | Cách đánh giá phù hợp |
|---|---|---|---|
| Phân loại | Nhãn hoặc nhóm | Yêu cầu này thuộc bộ phận nào? | Precision/recall, nhầm lẫn giữa các nhãn, chi phí phân loại sai |
| Dự đoán | Giá trị, thứ hạng hoặc xác suất | Nhu cầu tháng tới có thể thay đổi ra sao? | Sai số trên dữ liệu kiểm tra và độ ổn định theo thời gian |
| Tạo sinh | Văn bản, mã, hình ảnh hoặc nội dung khác | Hãy tóm tắt tài liệu và nêu câu hỏi còn thiếu | Đúng, đầy đủ, bám nguồn, an toàn và hữu ích theo rubric |
Đầu ra tạo sinh thường có nhiều câu trả lời chấp nhận được; vì vậy, kiểm tra từng kết quả bằng một “đáp án vàng” duy nhất có thể không phù hợp. Dùng rubric, ví dụ đối chứng, kiểm tra nguồn và đánh giá người dùng theo nhiệm vụ. Nếu ứng dụng có tác động cao, đặt tiêu chí lỗi nghiêm trọng riêng, không gộp tất cả vào điểm trung bình.
Mô hình tạo nội dung như thế nào?
Mô hình được huấn luyện trên các ví dụ để điều chỉnh tham số sao cho nhận ra quan hệ trong dữ liệu. Khi sử dụng, hệ thống nhận một đầu vào (prompt, hình, âm thanh hoặc dữ liệu khác tùy khả năng), biến nó thành biểu diễn bên trong và sinh đầu ra theo từng bước. Với mô hình ngôn ngữ, quy trình thường dự đoán token tiếp theo dựa trên ngữ cảnh; cách diễn đạt “dự đoán token” mô tả cơ chế sinh, không có nghĩa mọi hệ thống chỉ làm việc với văn bản.
Prompt là chỉ dẫn hoặc dữ liệu được cung cấp cho model để định hướng kết quả. Prompt có thể nêu nhiệm vụ, bối cảnh, ví dụ, nguồn được phép, định dạng và tiêu chí. Inference là giai đoạn dùng mô hình đã huấn luyện để tạo phản hồi. Model nền tảng là mô hình lớn được huấn luyện trước trên nhiều dạng dữ liệu và có thể được điều chỉnh hoặc kết nối với ứng dụng cụ thể. Đây là các khái niệm kỹ thuật có ý nghĩa khác nhau, không phải từ đồng nghĩa với “AI”.
Ứng dụng thực tế thường thêm lớp xung quanh model: xác thực người dùng, kiểm tra đầu vào, truy xuất tài liệu, gọi công cụ, lọc dữ liệu, tạo định dạng đầu ra, log và giám sát. Ví dụ, trợ lý hỏi đáp nội bộ có thể tìm đúng đoạn trong tài liệu mà người dùng được phép xem rồi yêu cầu model trả lời có trích dẫn. Chất lượng khi ấy phụ thuộc cả truy xuất, policy, phiên bản dữ liệu và giao diện, không chỉ model.
Các dạng đầu ra và ứng dụng
- Văn bản: dàn ý, giải thích, tóm tắt, dịch, phân tích và bản nháp email. Người dùng cần rà số liệu, trích dẫn, tên riêng và sắc thái trước khi phát hành.
- Mã: gợi ý hàm, test, tài liệu hoặc cách giải lỗi. Cần đọc diff, kiểm tra dependency, chạy test và đảm bảo không lộ secret.
- Hình ảnh: tạo minh họa hoặc biến đổi hình theo mô tả. Kiểm tra quyền với dữ liệu đầu vào, lỗi hình ảnh và mục đích sử dụng.
- Âm thanh/giọng nói: có thể tạo, chuyển lời nói hoặc tóm tắt nội dung tùy công cụ. Xác minh danh tính, quyền ghi âm và cách dùng giọng mô phỏng.
- Đầu ra đa phương thức: kết hợp văn bản với hình, âm thanh hoặc video ở những hệ thống hỗ trợ. Không mặc định một model hay gói nào cũng xử lý mọi modality.
Ở công việc văn phòng, AI tạo sinh hữu ích cho bước khởi thảo khi dữ liệu và kỳ vọng đã rõ: tạo vài cách trình bày, chuyển ghi chú thành cấu trúc, hoặc giúp người dùng khám phá một chủ đề. Trong phát triển phần mềm, nó có thể đề xuất mã nhưng developer vẫn chịu trách nhiệm kiến trúc và kiểm tra. Trong dịch vụ khách hàng, có thể tạo bản nháp từ tài liệu đã duyệt, còn nhân viên xử lý ngoại lệ và tình huống nhạy cảm.
Chọn cách dùng AI tạo sinh theo mục tiêu
| Nhu cầu | Cách bắt đầu | Điều kiện để kết quả dùng được | Khi không nên giao toàn bộ cho AI |
|---|---|---|---|
| Tạo bản nháp nội dung | Nêu độc giả, mục tiêu, dữ kiện, giọng và độ dài | Biên tập viên kiểm chứng claim và nguồn | Thông tin chưa công bố hoặc nội dung ràng buộc pháp lý |
| Tóm tắt tài liệu | Chỉ định nguồn và cấu trúc cần trả về | So với tài liệu gốc; dẫn đoạn hoặc trang | Nguồn mâu thuẫn, cũ hoặc người đọc cần quyết định rủi ro cao |
| Hỗ trợ lập trình | Đưa ví dụ tối thiểu, hành vi mong đợi và lỗi | Review diff, test, quét dependency và quyền truy cập | Code xử lý thanh toán, xác thực, dữ liệu nhạy cảm chưa có reviewer |
| Phân tích dữ liệu | Giải thích schema và câu hỏi nghiệp vụ | Kiểm tra công thức, bộ lọc, missing values và mẫu số | Dữ liệu không được phép chia sẻ hoặc kết luận cần chuyên gia |
| Tạo ảnh/âm thanh | Mô tả bối cảnh, phong cách, mục đích và giới hạn | Rà quyền, tính chân thực, chất lượng và bối cảnh văn hóa | Danh tính thật, bằng chứng hoặc nội dung có thể gây hiểu lầm |
Ví dụ thực tế và prompt mẫu
Một nhóm vận hành muốn biến ghi chú sau họp thành báo cáo nội bộ. Nếu yêu cầu đơn giản là “viết báo cáo”, model có thể tự thêm nguyên nhân, số liệu hoặc kết luận chưa được ghi nhận. Thay vào đó, nhóm xác định bốn nguồn được phép: quyết định đã ghi, đầu việc, người phụ trách và ngày dự kiến. Đầu ra tách “đã thống nhất”, “đang chờ”, “chưa có căn cứ”; người chủ trì xem lại trước khi chia sẻ.
Nhiệm vụ: chuyển ghi chú cuộc họp thành bản tóm tắt để người tham dự rà soát.
Nguồn duy nhất: nội dung bên dưới; không thêm sự kiện ngoài nguồn.
Trả về: quyết định, đầu việc/người phụ trách/hạn, câu hỏi còn mở.
Với thông tin không có trong ghi chú, ghi “chưa nêu”.
Giữ nguyên số liệu và ngày như nguồn; trích nguyên cụm liên quan khi cần.
Không tự gửi, giao việc hay lưu dữ liệu ở nơi khác.

Ghi chú: [chỉ dán nội dung đã được phép sử dụng]
Người dùng kiểm tra xem có đầu việc bị gán nhầm, hạn bị suy diễn hay quyết định bị diễn đạt mạnh hơn ghi chú. Nếu kết quả tạo được bản nháp tốt, workflow có ích; nếu người dùng phải sửa phần lớn, cần cải thiện nguồn, cấu trúc ghi chú hoặc chọn công cụ khác. Prompt không thay thế kiểm tra quyền truy cập hoặc chính sách dữ liệu.
Giới hạn, rủi ro và cách kiểm chứng
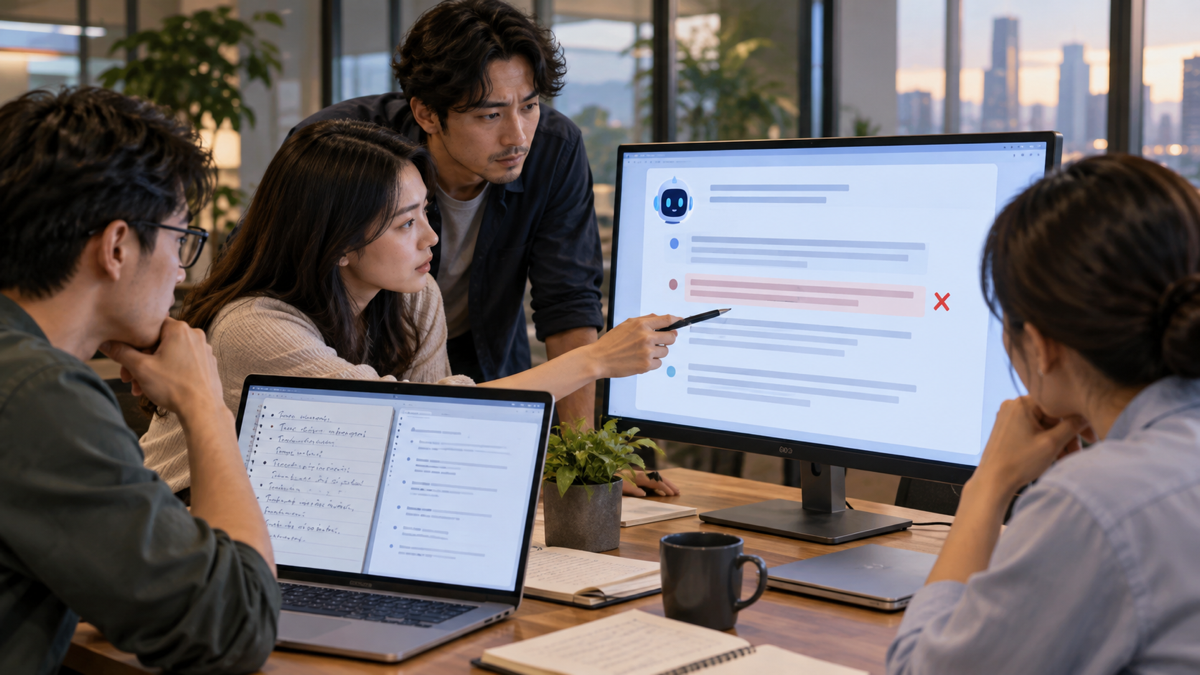
Hallucination: mô hình có thể tạo câu có vẻ hợp lý nhưng không đúng. Kiểm tra mệnh đề quan trọng với nguồn gốc, đặc biệt ngày tháng, số liệu, quy định và thông tin y tế/tài chính. Yêu cầu nêu rõ khi thiếu bằng chứng; đừng xem lời khẳng định “đã kiểm tra” là bằng chứng.
Thiên lệch và thiếu đại diện: dữ liệu huấn luyện hoặc cách đặt câu hỏi có thể làm một nhóm, ngôn ngữ hay bối cảnh bị mô tả kém. Với tác vụ ảnh hưởng người dùng, thử theo nhóm liên quan và có quy trình tiếp nhận sửa sai. Không dùng đầu ra làm căn cứ duy nhất cho quyết định nhân sự, tín dụng hay quyền lợi.
Riêng tư và bảo mật: prompt có thể chứa dữ liệu cá nhân, nội dung nội bộ hay khóa truy cập. Trước khi tải lên, xác định công cụ có được tổ chức duyệt, dữ liệu nào được lưu, ai truy cập và thời hạn giữ. Cũng cần tính tới prompt injection từ tài liệu không tin cậy khi ứng dụng đọc web, email hoặc file.
Quyền và nguồn: việc tạo nội dung không tự giải quyết quyền với dữ liệu đầu vào hoặc đầu ra. Lưu nguồn tham khảo, kiểm tra license của model/công cụ và xin phép khi cần. Với hình ảnh người thật, tác phẩm có bản quyền hoặc giọng nói, kiểm tra quyền và mục đích trước khi tạo hay chia sẻ.
NIST AI Risk Management Framework khuyến nghị quản lý rủi ro xuyên vòng đời và cung cấp một profile riêng cho generative AI. Trong ứng dụng, chuyển nguyên tắc thành hành động: lập danh sách tác vụ được phép, giới hạn dữ liệu và quyền, chuẩn bị tập test, theo dõi lỗi và chỉ rõ ai xử lý sự cố. Khung tham chiếu giúp tổ chức cấu trúc công việc; nó không đảm bảo một hệ thống cụ thể an toàn chỉ vì đã được nhắc tới.
Câu hỏi thường gặp
Generative AI có phải lúc nào cũng dùng mô hình ngôn ngữ lớn?
Không. AI tạo sinh có thể tạo nhiều loại đầu ra bằng các kiến trúc khác nhau. Mô hình ngôn ngữ lớn phù hợp một số tác vụ văn bản, nhưng không phải mọi model tạo hình ảnh, âm thanh hoặc video đều là LLM.
Generative AI có hiểu nội dung như con người không?
Không nên mặc định như vậy. Mô hình tạo phản hồi theo mẫu và ngữ cảnh học được; câu trả lời có thể trôi chảy nhưng sai hoặc thiếu. Dùng nguồn và chuyên môn con người để xác minh khi kết quả quan trọng.
AI tạo sinh có thể thay thế tìm kiếm không?
Không hoàn toàn. Tìm kiếm truy xuất tài liệu; mô hình tạo sinh diễn đạt hoặc tổng hợp nội dung. Ứng dụng có thể kết hợp hai cách, nhưng cần hiển thị nguồn để người dùng kiểm tra.
Vì sao cùng prompt nhưng kết quả khác nhau?
Kết quả có thể thay đổi theo model, phiên bản, ngữ cảnh, cấu hình sinh và dữ liệu được đưa vào. Nếu tính ổn định quan trọng, ghim phiên bản khi có thể và chạy tập kiểm thử hồi quy sau thay đổi.
Có nên dùng AI tạo sinh cho thông tin nhạy cảm?
Chỉ khi dịch vụ, cấu hình, quyền truy cập và chính sách tổ chức cho phép. Loại bỏ dữ liệu không cần thiết, kiểm tra retention và không dán mật khẩu hoặc secret vào prompt.
Làm sao biết công việc nào phù hợp?
Chọn tác vụ có đầu ra kiểm tra được, rủi ro lỗi chấp nhận được và người dùng có thể sửa. Thử trên một tập tình huống đại diện, đo thời gian xử lý cả phần review rồi so với cách làm hiện tại.
Kết luận
Generative AI mở rộng khả năng tạo và biến đổi nội dung, nhưng giá trị phụ thuộc vào bài toán, dữ liệu, cách tích hợp và quy trình kiểm chứng. Hãy dùng nó cho bước mà đầu ra có thể đánh giá, giữ nguồn và quyền rõ ràng, rồi tăng phạm vi dựa trên kết quả đo được.

Bình luận (0
)