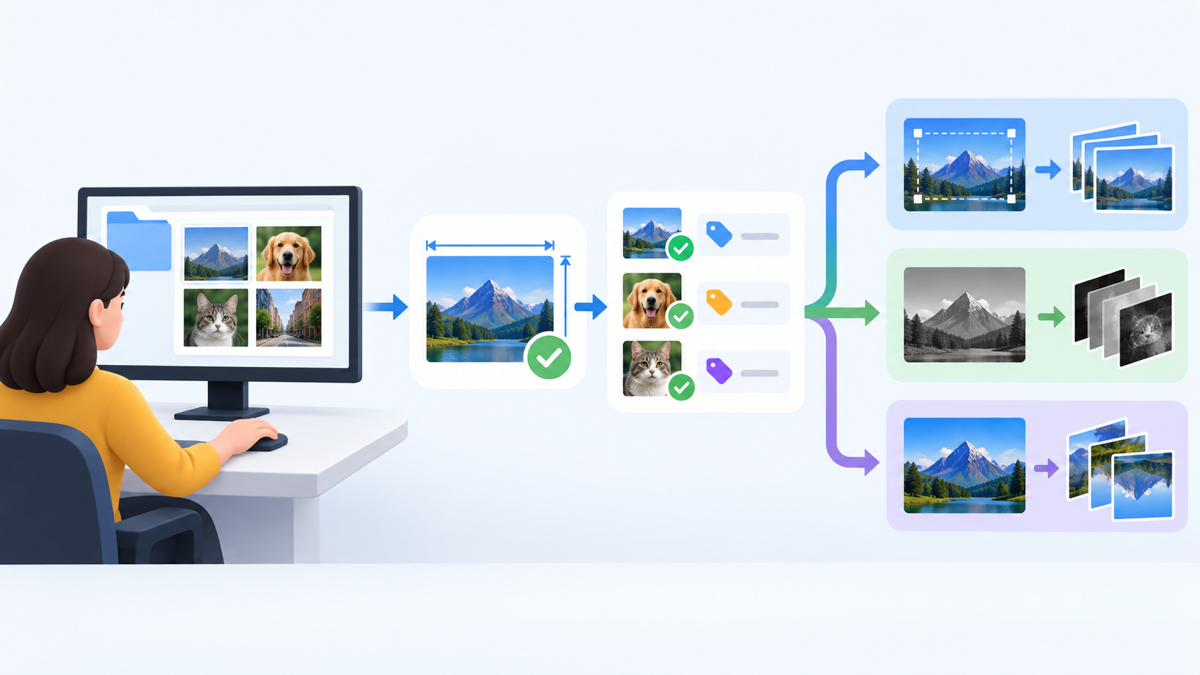
Quiz không có lựa chọn nên chưa thể chốt đáp án dự kiến. Với pipeline xử lý ảnh, trước hết xác định nhiệm vụ và kiểm tra tệp, định dạng, kích thước cùng nhãn; sau đó mới tiền xử lý phù hợp như đổi kích thước hoặc chuẩn hóa pixel.
Câu hỏi thiếu phương án
“Khi kiểm tra dữ liệu dạng hình ảnh AI thực hiện công việc gì trước tiên” giống câu hỏi trắc nghiệm nhưng không có đáp án hoặc ngữ cảnh môn học. Có thể có nhiều bước hợp lý tùy nhiệm vụ: kiểm tra file, đọc nhãn, resize ảnh, chuyển màu, OCR, phát hiện đối tượng hoặc tạo embedding. Không đủ căn cứ để khẳng định lựa chọn duy nhất mà người ra đề muốn.
Nếu hiểu theo pipeline học máy thông thường, trước khi đưa ảnh vào mô hình cần xác định bài toán, kiểm tra dữ liệu và chuẩn bị đầu vào tương thích. Với OCR, trọng tâm có thể là đọc định dạng và chất lượng scan; với classification, kiểm tra nhãn và kích thước; với object detection, phải xem bounding boxes có khớp đối tượng. “Tiền xử lý ảnh” không phải một chuỗi cố định áp dụng cho mọi mục đích.
Xác định nhiệm vụ trước khi xử lý ảnh
Hỏi hệ thống phải tạo đầu ra nào. Phân loại gán một nhãn cho ảnh; object detection xác định nhiều vật thể cùng vị trí; segmentation đánh dấu vùng pixel; OCR đọc chữ; image retrieval tìm ảnh tương tự; kiểm duyệt ảnh nhận diện nhóm nội dung theo định nghĩa. Mỗi bài toán cần nhãn và metric khác. Nếu chưa định nghĩa output, không thể biết ảnh nào bị lỗi hay phép biến đổi nào là hợp lệ.
Ví dụ, lật ảnh ngang có thể giữ nguyên ý nghĩa ảnh phong cảnh nhưng làm đảo chữ trên biển báo và hướng trái/phải trong ảnh y tế. Crop có thể giúp mô hình tập trung vật thể nhưng cắt mất bộ phận cần nhận diện. Chuyển grayscale có thể phù hợp một tác vụ văn bản nhưng xóa thông tin màu cần cho phân biệt sản phẩm. Vì vậy, mọi biến đổi nên dựa trên đặc điểm dữ liệu thật.
Kiểm tra đầu vào
Trước khi huấn luyện hoặc inference, xác nhận file mở được, không hỏng, đúng định dạng hỗ trợ, số kênh màu như mong đợi, chiều rộng/cao không bằng 0 và dữ liệu không bị cắt sai. Kiểm tra ảnh trùng, ảnh gần trùng, watermark, dữ liệu cá nhân, nhãn rỗng, class hiếm và nguồn thu thập. Với dữ liệu do người dùng gửi, đánh giá quyền lưu/xử lý và quy tắc retention trước.
Quan sát phân phối kích thước, tỷ lệ, độ sáng, độ phân giải, thiết bị chụp và nhóm dữ liệu. Một tập huấn luyện chỉ có ảnh studio sáng đều trong khi dữ liệu thực tế gồm ảnh tối từ điện thoại có thể tạo domain shift. Nếu ảnh có EXIF hoặc thông tin vị trí, xem chính sách loại bỏ metadata khi không cần lưu. Không chia sẻ dữ liệu nhận diện được lên công cụ bên ngoài nếu chưa được phép.
| Kiểm tra | Ví dụ lỗi | Cách xử lý phù hợp | Không nên làm |
|---|---|---|---|
| File và định dạng | File hỏng, codec không hỗ trợ, ảnh rỗng | Ghi lỗi, cách ly file, kiểm tra nguồn tạo | Bỏ qua âm thầm và làm sai số mẫu |
| Kích thước/tỷ lệ | Ảnh lệch kích thước, quá nhỏ, bị kéo méo | Đặt quy tắc resize/crop theo nhiệm vụ | Ép mọi ảnh méo tỷ lệ mà không thử |
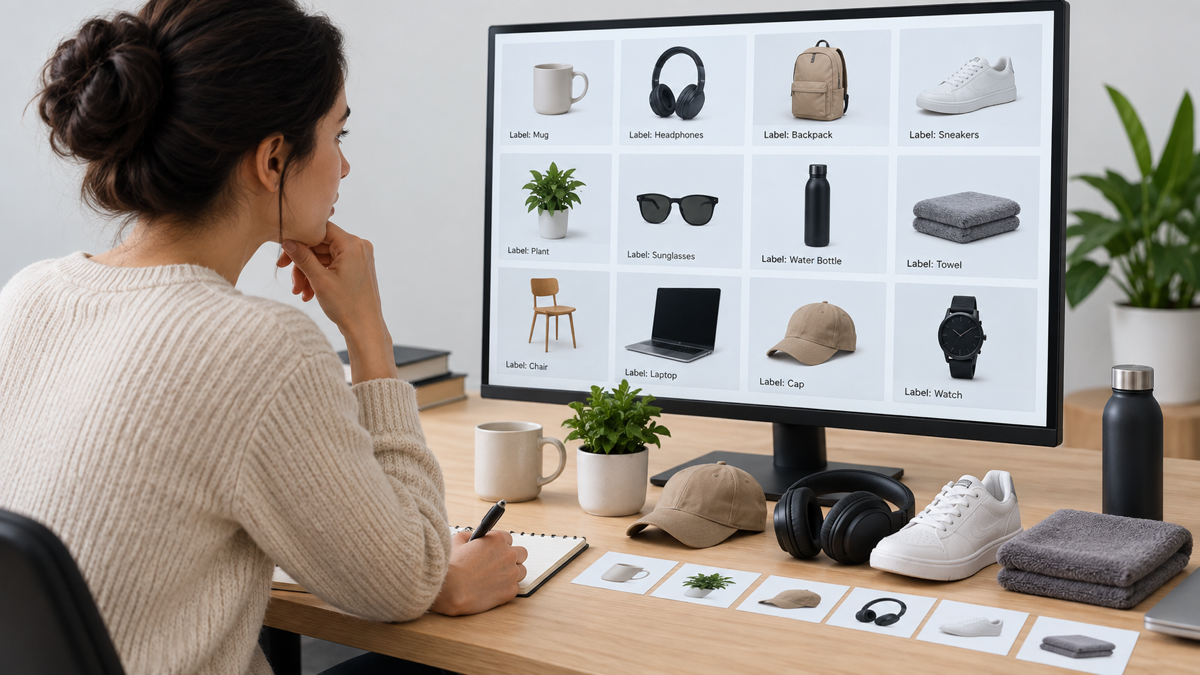
| Nhãn | Sai lớp, thiếu box, nhãn không thống nhất | Audit mẫu theo hướng dẫn annotation | Để model học từ nhãn sai |
| Trùng lặp/rò rỉ | Ảnh cùng cảnh xuất hiện cả train và test | Group/split theo người, video, phiên chụp phù hợp | Chỉ chia ngẫu nhiên từng file |
| Quyền/riêng tư | Ảnh có mặt, biển số hoặc vị trí | Kiểm tra cơ sở, tối thiểu hóa và giới hạn truy cập | Đưa ảnh nhạy cảm vào dịch vụ chưa duyệt |
Tiền xử lý theo bài toán
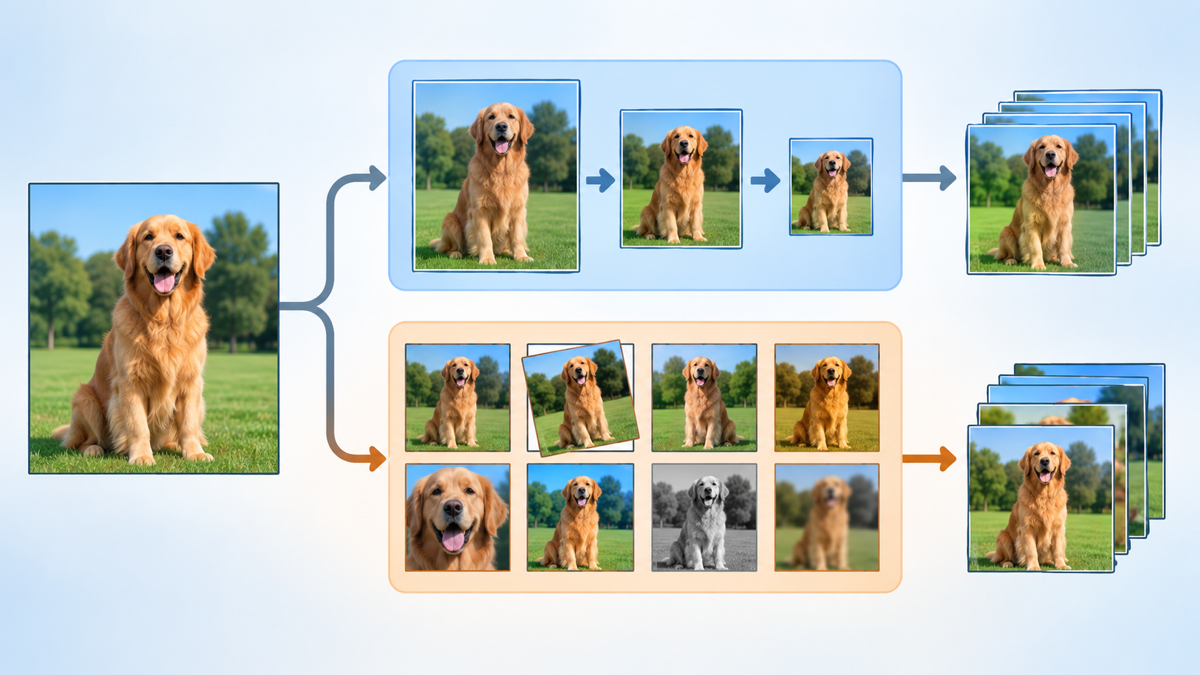
Resize đưa ảnh về kích thước đầu vào; rescale chuẩn hóa giá trị pixel về dải mong muốn; crop chọn vùng; color conversion thay đổi biểu diễn màu; deskew điều chỉnh độ nghiêng; augmentation tạo biến thể hợp lý cho dữ liệu huấn luyện. TensorFlow có các lớp Keras như Resizing, Rescaling, RandomFlip và RandomRotation, nhưng ví dụ tutorial không phải chỉ dẫn áp dụng nguyên xi cho mọi loại ảnh.
Trong classification, có thể dùng kích thước cố định và chuẩn hóa theo model. Trong OCR, giữ độ phân giải ký tự và thứ tự trang quan trọng. Trong detection, resize/crop cần cập nhật tọa độ bounding box tương ứng. Trong ảnh vệ tinh hoặc ảnh y khoa, màu/kích thước có thể mang thông tin; phải theo tiêu chuẩn domain và được chuyên gia xác nhận.
Augmentation chỉ nên mô phỏng biến thiên có thể xảy ra ngoài thực tế và không phá nhãn. Bài FUNiX về tăng cường dữ liệu cho nhận dạng hình ảnh trình bày riêng các phép biến đổi như xoay, lật và đổi sáng; hãy kiểm tra chúng có giữ nhãn cho bài toán của bạn hay không. Nếu ảnh phân biệt mèo/chó, xoay nhẹ có thể hợp lệ; nếu nhãn là “mũi tên chỉ trái”, flip ngang sẽ biến đổi nhãn. Tách augmentation cho train; validation/test dùng quy trình tiền xử lý nhất quán, không thêm biến thể ngẫu nhiên làm kết quả đánh giá khó lặp lại.
Ví dụ: phân loại ảnh sản phẩm
Nhóm muốn phân loại ảnh sản phẩm thành “bình nước” hoặc “ly”. Đầu tiên, họ kiểm tra tất cả ảnh mở được, nhãn có đúng, và tập train/test không chứa các góc chụp gần như giống nhau từ cùng một buổi chụp ở cả hai phía. Nếu một mẫu duy nhất bị copy nhiều lần, chia ngẫu nhiên theo file sẽ khiến test quá dễ.
Sau đó nhóm thống nhất cách resize giữ tỷ lệ hoặc padding, và rescale pixel như cấu hình model yêu cầu. Họ xem ảnh sau biến đổi để chắc vật thể còn trong khung và nhãn không bị thay. Nếu ảnh có logo/giá tiền nền phía sau, quyết định giữ hay loại cần dựa trên mục tiêu mô hình; không để model học logo thay vì hình dạng sản phẩm nếu muốn tổng quát. Người mới thử phân loại ảnh có thể xem ví dụ Teachable Machine trong bài bước vào kỷ nguyên AI không cần biết lập trình, rồi quay lại kiểm tra pipeline và nhãn trên bộ dữ liệu của mình.
| Trường hợp | Quan sát | Quyết định | Kiểm tra sau xử lý |
|---|---|---|---|
| Ảnh dọc/ngang khác nhau | Resize vuông làm méo sản phẩm | Chọn resize giữ tỷ lệ và padding/crop phù hợp | Vật thể còn đầy đủ, nhãn không đổi |
| Ảnh tối | Màu và đường viền thay đổi | Thử điều chỉnh sáng có giới hạn hoặc thu thêm dữ liệu | Không tạo màu giả so với thực tế |
| Ảnh trùng | Khác độ nén nhưng cùng khung | Gom nhóm trước khi chia train/test | Không có nhóm gần trùng xuyên tập |
| Nhãn mơ hồ | Sản phẩm vừa là ly vừa thuộc bộ bình | Chốt hướng dẫn annotation hoặc thêm nhãn | Người gán nhãn thống nhất trên mẫu |
Chia tập và kiểm tra nhãn
Tập train dùng để học, validation để chọn cấu hình, test để đánh giá cuối theo quy trình đã định. Nếu có nhiều ảnh từ cùng người, video, sản phẩm hoặc địa điểm, split theo nhóm để giảm rò rỉ tương tự. Giữ tỉ lệ class phù hợp khi cần, nhưng không đánh đổi khả năng phản ánh thực tế để cân bằng giả tạo. Lưu seed, manifest và phiên bản nhãn để người khác tái tạo kết quả.
Kiểm tra nhãn bằng mẫu ngẫu nhiên và nhóm lỗi rủi ro cao. Đối với segmentation, overlay mask lên ảnh để kiểm tra biên; với detection, hiển thị bounding boxes; với OCR, đối chiếu text với scan. Nhãn sai có thể khó phát hiện nếu chỉ nhìn metric tổng. Khi sửa nhãn sau này, ghi lại lý do và đánh giá lại model theo phiên bản dữ liệu mới.
Lỗi thường gặp
- Resize trước khi hiểu tác vụ: kiểm tra tỷ lệ và thông tin cần giữ trước khi chốt transform.
- Augment mọi tập dữ liệu: áp dụng biến thể ngẫu nhiên cho test khiến so sánh mất ổn định.
- Nhầm tiền xử lý với tăng cường dữ liệu: resize/rescale chuẩn hóa; flip/rotate tạo biến thể và chỉ phù hợp nếu nhãn giữ nguyên.
- Bỏ qua ảnh trùng: leakage có thể làm điểm test lạc quan.
- Tin nhãn cũ: audit quy tắc và ví dụ bất đồng giữa người gán nhãn.
- Không lưu pipeline: ghi lại bước transform cùng model để production dùng đúng tiền xử lý.
Thuật ngữ liên quan
- Image preprocessing: biến đổi đầu vào để đáp ứng định dạng/kích thước model hoặc cải thiện điều kiện nhận dạng.
- Data augmentation: tạo biến thể có chủ đích cho train để mô phỏng biến thiên thực tế mà không làm sai nhãn.
- Label/annotation: thông tin mục tiêu gắn cho ảnh, như lớp, bounding box hoặc pixel mask.
- Data leakage: thông tin liên quan kết quả/ảnh trùng lọt vào tập đánh giá, khiến metric không phản ánh khả năng tổng quát.
- Domain shift: khác biệt giữa phân phối ảnh huấn luyện và ảnh khi dùng thật.
Câu hỏi thường gặp
AI luôn phải resize ảnh trước khi phân tích?
Không. Đầu vào có thể phải theo shape cụ thể của mô hình, nhưng bước nào đầu tiên phụ thuộc pipeline. Trước hết kiểm tra tác vụ và file; chỉ resize khi yêu cầu kỹ thuật hoặc thiết kế xử lý đòi hỏi.
Quiz không cho đáp án thì có thể chốt preprocessing không?
Không thể suy ra đáp án dự kiến. Có thể nói quy trình thường kiểm tra dữ liệu và chuẩn bị input; đề cần đủ lựa chọn hoặc tài liệu học để xác định cụ thể bước được hỏi.
Data augmentation có áp dụng cho validation/test không?
Thông thường augmentation ngẫu nhiên dùng cho train. Validation/test cần tiền xử lý nhất quán để đánh giá có thể so sánh; nếu dùng test-time augmentation, đó phải là thiết kế riêng và được ghi rõ.
Ảnh càng lớn thì mô hình càng tốt?
Không nhất thiết. Độ phân giải cao có thể giữ chi tiết nhưng tăng bộ nhớ/thời gian. Chọn kích thước dựa trên kích thước đặc trưng, model, tài nguyên và metric trên validation.
Ảnh bị nhãn thiếu có nên tự gán nhãn bằng AI?
AI có thể đề xuất nhãn để người kiểm tra, nhưng nhãn tự động cần validation, hướng dẫn thống nhất và xử lý trường hợp không chắc. Không đưa dữ liệu nhạy cảm vào hệ thống chưa được phép.
Vì sao metric tốt nhưng model chạy thật kém?
Có thể do leakage, phân phối ảnh khác, nhãn sai, tiền xử lý không giống train, hoặc metric không phản ánh tác vụ. Kiểm tra theo nhóm dữ liệu và log pipeline trước khi kết luận cần đổi model.

Bình luận (0
)