Semantic Caching tìm truy vấn đã lưu gần nghĩa với yêu cầu mới để dùng lại phản hồi thay vì gọi model. Cơ chế thường dùng embedding và tìm kiếm tương đồng, nhưng câu gần nghĩa chưa chắc phù hợp cùng câu trả lời. Cần kiểm tra quyền, ngữ cảnh, độ mới và chất lượng trước khi bật.
Cơ chế Semantic Caching
Cache thông thường thường khớp theo key chính xác: cùng URL/tham số hoặc cùng chuỗi truy vấn thì có thể tra lại kết quả. Semantic cache chuyển văn bản thành vector, tìm vector gần trong chỉ mục và xác định có phản hồi nào đủ giống để tái sử dụng hay không. Ví dụ, “cách đổi mật khẩu tài khoản?” và “tôi muốn đặt mật khẩu mới như thế nào?” có thể được coi là gần nghĩa trong một miền FAQ.
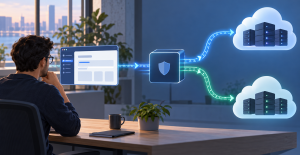
Trong tài liệu Apigee của Google Cloud, semantic caching được mô tả qua policy lookup ở luồng request và policy populate ở luồng response. Request được chuyển thành biểu diễn số để tìm prompt tương tự; nếu tìm thấy kết quả trong cache thì có thể trả lại, còn không thì gọi model rồi lưu response. Đây là cách một sản phẩm triển khai tính năng; kiến trúc cụ thể và giới hạn khác nhau tùy hệ thống.
Điểm dễ gây lỗi là similarity đo mức gần của cách diễn đạt, không chứng minh hai yêu cầu có cùng quyền, điều kiện hoặc thời điểm. “Chính sách nghỉ phép” và “chính sách nghỉ phép của nhân viên thử việc” có thể gần nhau nhưng khác điều kiện. “Giờ mở cửa hiện tại” cần dữ liệu theo thời gian, còn câu hỏi chung về cách tìm địa chỉ có thể ổn định hơn.
Semantic cache thường được đặt trước model sau các bước xác thực và chuẩn hóa phù hợp. Nó không nên bỏ qua authorization hoặc lấy cache hit làm bằng chứng rằng dữ liệu được phép xem. Việc chọn cache key, metadata và phạm vi tenant cần được thiết kế cùng luồng truy xuất để một câu trả lời cá nhân hóa không bị trả nhầm cho người khác.
Thuộc tính cần quản lý
Mỗi quyết định dùng cache cần đủ thông tin để tái hiện và xóa kết quả sai. Thuộc tính tối thiểu phụ thuộc hệ thống, nhưng các nhóm sau cần được cân nhắc rõ.
- Query và embedding: phần văn bản nào được biểu diễn, mô hình embedding/phiên bản nào tạo vector.
- Cache key/ngữ cảnh: tenant, role, locale, tác vụ, phiên bản nguồn, model hoặc cấu hình trả lời nếu chúng ảnh hưởng kết quả.
- Điểm tương đồng: similarity score, metric, ngưỡng hit và cách phân biệt “không đủ gần”.
- Payload được lưu: response, citations, metadata và thông tin không được phép đưa vào cache.
- Thời hạn: TTL theo độ biến động của nguồn, ngày tạo, ngày hết hạn và điều kiện buộc bỏ cache.
- Invalidation: sự kiện xóa khi nguồn, quyền, sản phẩm, giá trị hay chính sách thay đổi.
- Kiểm soát truy cập: ai được đọc, tạo, invalidation hoặc export cache; quyền có được kiểm tra lại ở mỗi hit?
- Telemetry: hit/miss, route, latency, chất lượng đã đánh giá và lý do cache bị từ chối.
| Quyết định | Câu hỏi thiết kế | Rủi ro nếu bỏ qua |
|---|---|---|
| Cache key | Những ngữ cảnh nào làm thay đổi câu trả lời? | Trả response của tenant/role/ngôn ngữ hoặc tác vụ khác. |
| Similarity threshold | Trên tập đánh giá, mức nào giữ đủ hit nhưng không trộn câu khác điều kiện? | Ngưỡng thấp gây false hit; ngưỡng cao giảm cache hit mà vẫn tốn embedding lookup. |
| TTL | Nguồn đổi nhanh hay chậm? Câu trả lời còn đúng tới khi nào? | Nội dung hết hiệu lực tiếp tục được trả như thông tin hiện hành. |
| Invalidation | Ai biết nguồn/quyền thay đổi và tín hiệu nào xóa cache? | Xóa muộn khiến kết quả cũ tồn tại sau khi nguồn đã sửa. |
| Dữ liệu lưu | Response có dữ liệu người dùng hoặc bí mật không? | Cache thành kho dữ liệu thứ cấp với quyền/retention chưa rõ. |
| Metric | Cache hit có giữ chất lượng và giảm chi phí/latency ròng? | Tối ưu tỷ lệ hit trong khi chất lượng hoặc chi phí hệ thống xấu đi. |
Luồng tìm và trả cache
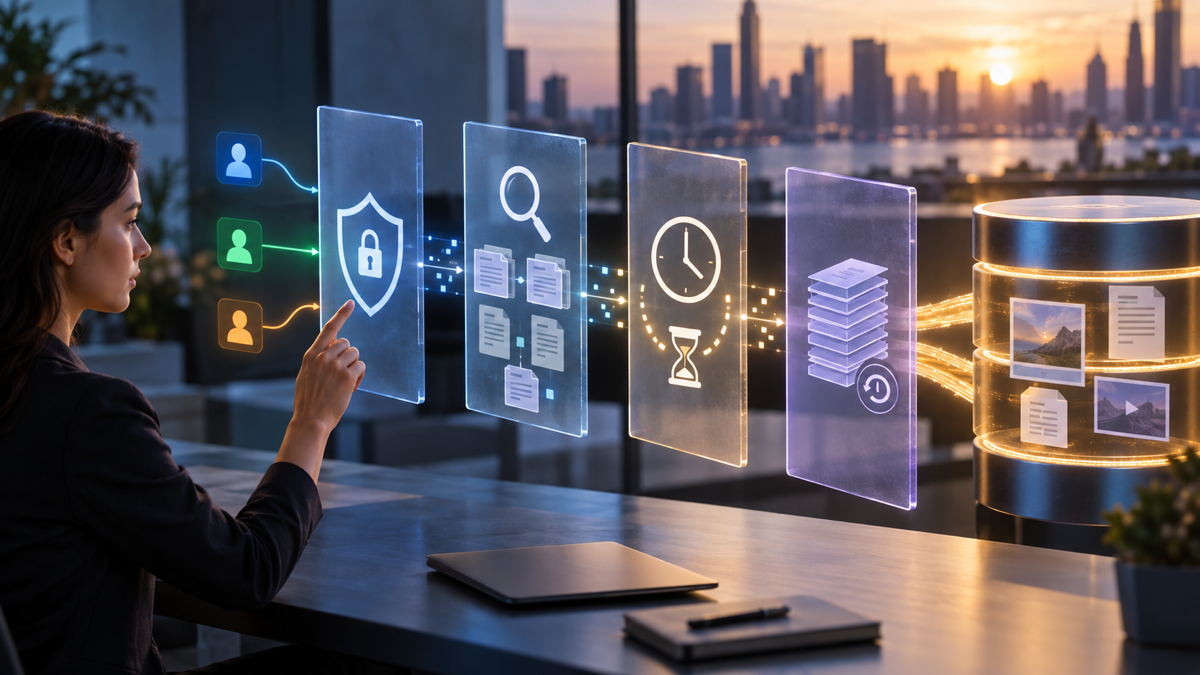
- Xác thực trước: xác định user, tenant và quyền truy cập trước khi tìm hoặc đọc cache.
- Chuẩn hóa tác vụ: tách yêu cầu, giữ metadata có ảnh hưởng như locale, bộ lọc thời gian, phiên bản nguồn và loại đầu ra.
- Đánh giá có cache hay không: loại các request chứa dữ liệu cá nhân, câu trả lời thay đổi theo người dùng hoặc trạng thái thời gian thực nếu chính sách không cho phép.
- Tạo embedding và tìm ứng viên: dùng phiên bản embedding đã định nghĩa; chỉ lấy candidate trong phạm vi dữ liệu và quyền phù hợp.
- Kiểm tra hit: so score với ngưỡng đã đánh giá, xác minh freshness và cache key. Nếu điều kiện không đạt, xem là miss.
- Trả kết quả hoặc gọi model: cache hit trả đúng response/citation đã lưu; cache miss đi tới model như bình thường, sau đó mới xét có thể populate không.
- Ghi dấu vết: lưu metadata cần đo, tránh ghi nội dung nhạy cảm không có mục đích; có đường invalidation và xử lý báo cáo cache sai.
Không phải hệ thống nào cũng dùng chính xác pipeline trên; một số sản phẩm đóng gói lookup/populate thành policy, một số đội tự xây. Dù triển khai cách nào, quyền và freshness cần được xác nhận trước khi trả response. Nếu cache miss làm gọi model còn cache hit không, thống kê chi phí phải tính cả embedding/search và vận hành index thay vì chỉ đếm model call tránh được.
Khi nào phù hợp?
Cache ngữ nghĩa đáng thử khi có nhiều request lặp lại về một miền nội dung tương đối ổn định, câu trả lời có thể tái sử dụng trong cùng ngữ cảnh và có cách đo chính xác/độ mới. FAQ chung về thao tác sản phẩm là một ứng viên tốt hơn thông tin theo hồ sơ cá nhân, số dư tài khoản, trạng thái giao dịch hoặc chính sách thay đổi theo thời điểm.
Semantic caching có thể giảm lượt gọi backend trong các hit phù hợp, nhưng không đảm bảo tổng độ trễ hoặc chi phí giảm. Trước mỗi cache lookup có thể cần tạo embedding và tìm vector; việc lưu, index, invalidation và đo chất lượng cũng tốn tài nguyên. Google Cloud mô tả cache semantic như một khả năng trong sản phẩm Apigee; lợi ích thực tế vẫn phụ thuộc workload và cấu hình.
Không nên chọn cache chỉ vì tỷ lệ hit cao. Tối ưu quá mạnh cho hit có thể trả nhiều kết quả sai ngữ cảnh. Với tác vụ mà phản hồi có tác động đến quyền, tài chính, sức khỏe, thông tin cá nhân hoặc hành động khó hoàn tác, nên tránh tái sử dụng nếu không có kiểm soát chặt và review theo chính sách.
Riêng với policy semantic cache của Apigee, tài liệu Google Cloud lưu ý các policy dùng LLM API và có thể làm độ trễ tăng thêm ở mức hàng trăm mili giây. Đây là giới hạn được nêu cho cách triển khai Apigee, không thể suy rộng thành con số chung cho mọi semantic cache. Vì vậy, hãy đo end-to-end trên traffic thật: so hit và miss, tính cả embedding, tìm kiếm, lưu trữ và thời gian gọi model; chỉ bật nếu lợi ích ròng đạt yêu cầu mà false hit vẫn trong ngưỡng chấp nhận.
Ví dụ và prompt thiết kế
Một trợ lý nội bộ trả lời câu hỏi về quy trình IT có một số chủ đề ổn định như cách cài ứng dụng và cách yêu cầu quyền. Nhóm muốn dùng cache để tránh lặp request. Họ giữ cache key gồm tenant, ngôn ngữ, loại quy trình và phiên bản nguồn; loại câu hỏi có dữ liệu hồ sơ cá nhân khỏi cache; đặt thời hạn ngắn hơn cho nội dung có thể thay đổi thường xuyên; khi owner cập nhật runbook, phát sự kiện xóa các entry liên quan.
Để xây ngưỡng, nhóm tạo cặp câu hỏi cùng ý nhưng khác cách diễn đạt, cùng chủ đề nhưng khác điều kiện, và hoàn toàn khác chủ đề. Chuyên viên gắn nhãn cặp nào được dùng cùng response. Sau đó nhóm thử các ngưỡng trên tập đó, đo false hit, miss, độ mới, latency đầu-cuối và chi phí truy xuất. Điểm số thử nghiệm không được áp dụng cho mọi hệ thống hoặc ngôn ngữ nếu chưa đánh giá tương tự.
Thiết kế chính sách semantic cache cho [loại câu hỏi]. Nêu các trường cần đưa vào cache key, nhóm truy vấn không nên cache, cách thử ngưỡng bằng cặp truy vấn được con người gán nhãn, TTL theo độ biến động, sự kiện invalidation, kiểm tra quyền tại hit và metric false-hit/miss/latency. Tách giả định khỏi quyết định. Không đề xuất một ngưỡng phổ quát và không dùng similarity score như bằng chứng rằng hai yêu cầu có cùng quyền hoặc cùng điều kiện.
Nguy cơ cache sai hoặc cũ
- False hit: truy vấn gần nghĩa nhưng khác một điều kiện quan trọng nhận câu trả lời không phù hợp.
- Cache cũ: chính sách, hướng dẫn hay trạng thái dịch vụ đổi nhưng entry chưa hết TTL hoặc chưa invalidated.
- Rò dữ liệu giữa ngữ cảnh: câu trả lời riêng của người dùng được trả sang tenant, role hoặc người khác.
- Citation không hợp lệ: response có link cũ hoặc link trỏ đúng nguồn nhưng đoạn đã thay đổi.
- Prompt injection dai dẳng: một response bị thao túng được lưu và tái sử dụng cho các request gần giống.
- Chi phí ẩn: embedding, vector search, cache store, invalidation và giám sát có thể bù một phần lợi ích.
- Độ trễ không giảm: lookup vector thêm bước; với ít request lặp, cache có thể chậm hơn gọi trực tiếp.
Google Cloud khuyến nghị cân nhắc TTL và invalidation để quản lý freshness; tài liệu cũng cảnh báo similarity không đủ phân biệt hai input gần nhau có thể dẫn tới response sai hoặc cũ. Các ví dụ TTL trong tài liệu của một sản phẩm là minh họa theo hướng dẫn đó, không phải giá trị mặc định phù hợp với dữ liệu của mọi doanh nghiệp.
Đánh giá trước khi bật
- False-hit rate: trong các hit được đề xuất, bao nhiêu cặp thực sự có thể dùng cùng response?
- Miss rate: có nhiều cặp được gán cùng ý nhưng không hit vì threshold quá chặt không?
- Độ mới: cache hit còn đúng với phiên bản nguồn tại thời điểm trả?
- Quyền: có bất kỳ entry nào được dùng ngoài user/tenant được phép?
- Chất lượng: điểm rubric và tỷ lệ citation hợp lệ của câu trả lời cached so với gọi lại model.
- Hiệu quả ròng: latency và chi phí đầu-cuối bao gồm embedding, tìm kiếm, lưu trữ và invalidation.
Checklist vận hành
- Chọn loại phản hồi ổn định và lặp lại; loại use case phụ thuộc user hoặc realtime nếu chưa kiểm soát.
- Định nghĩa cache key theo tenant, role, locale, tác vụ và version nguồn cần thiết.
- Tạo tập cặp truy vấn với nhãn tương đương/không tương đương.
- Chọn ngưỡng bằng đánh giá false hit, không lấy một con số từ bài hướng dẫn làm chuẩn phổ quát.
- Quy định TTL, invalidation, quyền truy cập và cách xóa dữ liệu.
- Đo chất lượng, freshness, latency và chi phí đầu-cuối song song với hit rate.
- Đặt nút tắt, báo lỗi cache và owner theo dõi thay đổi nguồn.
Semantic caching có liên hệ với lớp quản lý model và ứng dụng; xem cách RAG truy xuất nguồn cho câu trả lời và bản đồ kỹ năng xây dựng ứng dụng AI.
Nguồn tham khảo
- Google Cloud Apigee: Get started with semantic caching policies
- Google Cloud Apigee: Semantic caching limitations and private endpoint
Semantic cache có thể trả lại phản hồi đã lưu; cần kiểm tra tính phù hợp, quyền và độ mới trước khi dùng kết quả trong ứng dụng.
Câu hỏi thường gặp
Semantic cache khác cache theo chuỗi chính xác thế nào?
Cache theo key chính xác chỉ khớp khi key giống theo quy tắc đã đặt. Semantic cache biểu diễn truy vấn rồi tìm ứng viên gần nghĩa. Cách sau có thể bắt được cách diễn đạt khác nhau, nhưng cũng có nguy cơ coi hai câu khác điều kiện là tương đương.
Ngưỡng tương đồng nên đặt bao nhiêu?
Không có một mức dùng chung cho mọi model embedding, ngôn ngữ và miền dữ liệu. Tạo tập cặp query đã được người hiểu nghiệp vụ gán nhãn, thử các giá trị và đo false hit/miss. Kiểm tra lại khi thay embedding hoặc nguồn.
Khi nào cần invalidation?
Khi tài liệu, quyền, cấu hình, trạng thái dịch vụ hoặc điều kiện tạo response thay đổi đến mức cache không còn đúng. Gắn owner và sự kiện invalidation với nguồn dữ liệu, thay vì chỉ chờ TTL nếu nội dung có thể mất hiệu lực sớm.
Có thể dùng chung cache giữa các người dùng không?
Chỉ khi response thật sự không phụ thuộc identity, role, tenant hay dữ liệu cá nhân và quyền được xác minh tại mỗi hit. Nếu câu trả lời có trạng thái hồ sơ hoặc tài liệu phân quyền, không dùng một cache chung nếu chưa có cơ chế cô lập và kiểm tra.
Semantic Caching có chắc chắn giảm chi phí không?
Không. Nó có thể tránh một số model calls nhưng thêm embedding, vector search, storage, invalidation và giám sát. Đo chi phí/latency ròng cùng chất lượng trên traffic đại diện; tỷ lệ hit cao tự nó chưa chứng minh lợi ích.
Làm sao phát hiện response cũ hoặc sai?
Kiểm tra citation với phiên bản nguồn, lấy mẫu cache hit để chuyên viên chấm, theo dõi báo cáo người dùng và tạo test cho các cặp query gần nghĩa nhưng khác điều kiện. Đặt đường xóa entry và tắt cache khi thấy nguồn hoặc quyền bị lệch.

Bình luận (0
)