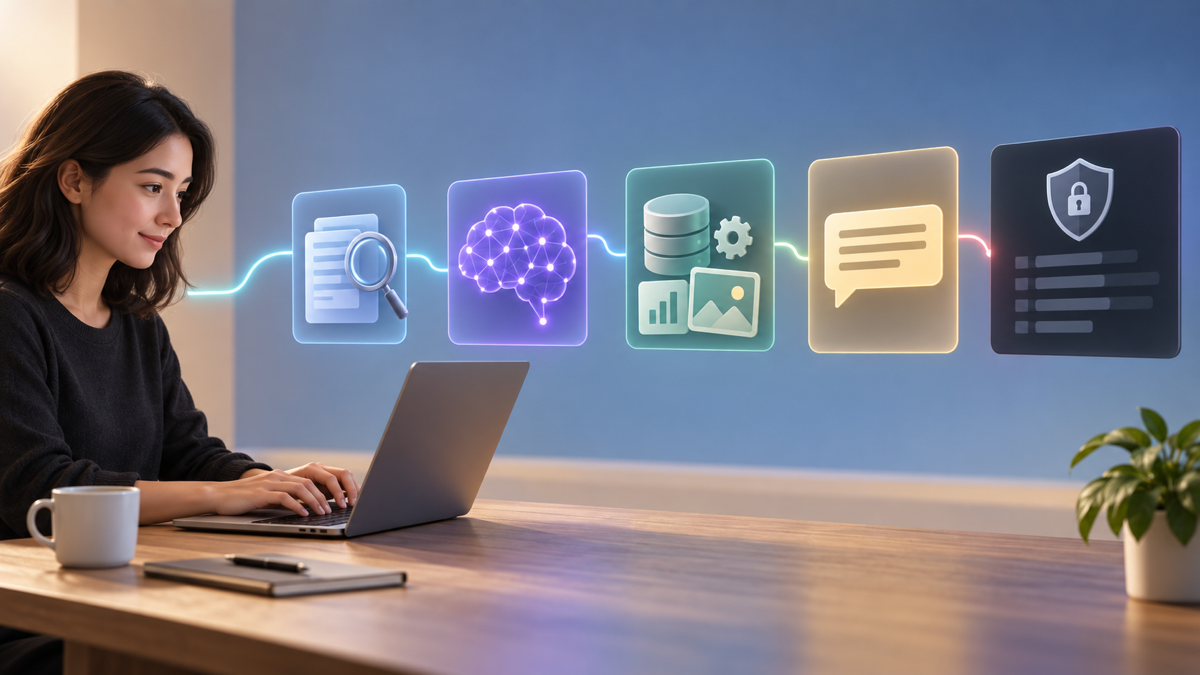
LLMOps quản lý ứng dụng dùng mô hình ngôn ngữ lớn từ prompt, dữ liệu và đánh giá đến triển khai, giám sát và phản hồi. Sau phát hành, nhóm theo dõi chất lượng, độ trễ, lỗi, chi phí và rủi ro dữ liệu; kiểm thử thay đổi trước khi đưa vào sử dụng.
Vì sao cần LLMOps?
Prototype dùng một prompt và vài câu hỏi mẫu có thể hoạt động tốt trong buổi demo, nhưng sản phẩm thật nhận nhiều câu hỏi, nhiều kiểu đầu vào và thay đổi theo thời gian. Nhà cung cấp có thể cập nhật model, kho tài liệu thay đổi, prompt được sửa, tool integration trục trặc hoặc lưu lượng tăng. Nếu không ghi phiên bản và dấu vết, nhóm khó biết lỗi bắt đầu từ đâu, người dùng nào bị ảnh hưởng hoặc có thể quay lại cấu hình trước hay không.
LLMOps kế thừa MLOps và DevOps, tập trung vào đặc trưng của ứng dụng LLM: đầu ra tự do, prompt, retrieval, tool calls, conversation context, safety và đánh giá chất lượng theo ví dụ. Một ứng dụng có thể gồm nhiều dịch vụ, không chỉ lời gọi model. Vì vậy, vận hành cần quan sát luồng từ câu hỏi đến truy xuất, gọi công cụ, sinh câu trả lời và phản hồi người dùng.
Nhóm nên ghi rõ phạm vi: ứng dụng trả lời loại câu hỏi nào, nguồn nào được phép dùng, hành động nào bị cấm, và ai phụ trách từng phần. Bài đánh giá ứng dụng LLM như thế nào tập trung vào đo chất lượng; bài RAG là gì trong AI giải thích lớp truy xuất có thể xuất hiện trong một hệ thống LLM.
Các thành phần cần quản lý
Không nhất thiết mọi nhóm phải cài một “LLMOps platform” riêng. Có thể bắt đầu bằng công cụ version control, bộ test, log có cấu trúc và bảng theo dõi thay đổi. Quan trọng là có câu trả lời cho từng câu hỏi vận hành:
- Prompt/instructions: ai sửa, phiên bản nào đang chạy, mục tiêu và ví dụ test nào đi kèm?
- Model/configuration: provider, model identifier, tham số, fallback, timeout, retry và giới hạn token được ghi ở đâu?
- Data/retrieval: nguồn nào được index, cập nhật khi nào, tài liệu nào được phân quyền, phiên bản embedding/chunking nào đang dùng?
- Evaluation set: ví dụ chuẩn, câu hỏi lỗi đã gặp và nhóm case an toàn nào dùng để kiểm tra regression?
- Tracing: request đi qua những bước nào, tool nào được gọi, latency và lỗi phát sinh ở đâu?
- Monitoring: ai nhận cảnh báo, chỉ số nào quan trọng, ngưỡng nào cần điều tra và cách giảm tác động?
- Feedback/incident: người dùng báo lỗi ra sao, ai phân loại, cần lưu gì và bao lâu?
- Access/data protection: log có chứa prompt/PII/secrets không, ai được xem, retention và redaction ra sao?
| Lớp | Ví dụ phiên bản/dấu vết | Chỉ số hoặc kiểm tra | Hành động khi lỗi |
|---|---|---|---|
| Prompt và logic ứng dụng | Commit, prompt ID, parser, tool schema | Eval regression, format-valid rate | Rollback bản prompt/logic đã biết tốt |
| Model/provider | Model, region, tham số và ngày đổi | Latency, error rate, output quality | Chuyển fallback nếu đã kiểm thử/cho phép |
| Retrieval/data | Snapshot nguồn, index, chunking, metadata | Retrieval relevance, freshness, ACL tests | Ngừng nguồn sai hoặc quay lại index hợp lệ |
| Serving/tool | Deploy ID, API contract, connector version | Timeout, tool failure, retry, concurrency | Tắt tool/action, chuyển người hoặc degradation an toàn |
| Người dùng và an toàn | Trace redacted, feedback, incident ID | Escalation rate, issue category, PII checks | Thu hẹp khả năng, thông báo và xử lý sự cố |
Ví dụ: trợ lý RAG nội bộ
Giả sử công ty có trợ lý trả lời câu hỏi về chính sách nghỉ phép từ tài liệu nội bộ. Mỗi trace cần cho nhóm biết câu hỏi được gửi, tài liệu nào được truy xuất, câu trả lời nào được tạo và người dùng có đánh dấu hữu ích không — trong khi log phải ẩn định danh và không lưu dữ liệu quá mức. Khi nhân sự báo câu trả lời nhầm phiên bản chính sách, nhóm kiểm tra document metadata, index refresh và citations thay vì chỉ viết prompt “hãy chính xác hơn”.
Trước khi sửa, nhóm thêm câu hỏi sự cố cùng kỳ vọng đúng vào eval set. Candidate được kiểm tra câu này, câu FAQ thông thường, câu ngoài phạm vi và quyền truy cập. Nếu tài liệu nguồn cập nhật, kiểm tra retrieval lấy đúng bản hiện hành. Nếu thay model, chạy cùng tập để xem chất lượng, latency và chi phí tương đối. Chỉ phát hành khi owner đánh giá regression chấp nhận được.
Nếu trace cho thấy nguồn đúng nhưng model trích sai điều kiện, sửa prompt hoặc định dạng context; nếu truy xuất sai, sửa metadata/index; nếu user không có quyền mà vẫn lấy được đoạn, xử lý access control ngay. Cách phân loại nguyên nhân giúp tránh vá sai lớp. Chất lượng ứng dụng là kết quả kết hợp của dữ liệu, retrieval, prompt, model, tool và giao diện.
Đánh giá trước khi phát hành
Chọn bộ ví dụ phản ánh tình huống thật: câu phổ biến, câu khó, câu mơ hồ, thiếu nguồn, prompt injection, dữ liệu nhạy cảm, lỗi tool và ngôn ngữ/định dạng khác nhau. Xác định tiêu chí riêng: đúng nguồn, đúng nội dung, không vượt phạm vi, format hợp lệ và thời gian phản hồi. Với mỗi ví dụ có thể lưu kỳ vọng hoặc rubric do người chuyên môn tạo.
So sánh phiên bản mới với bản đang chạy, không chỉ xem điểm tuyệt đối. Dùng human review cho case rủi ro cao và lấy mẫu cho các tiêu chí tự động. LLM-as-a-judge có thể tăng độ phủ đánh giá nhưng cũng cần hiệu chuẩn, so với ý kiến chuyên gia và theo dõi false positives/negatives. Không để một điểm tổng che lỗi nghiêm trọng về riêng tư hoặc quyền truy cập.
Đưa regression test vào trước release. Nếu prompt thay đổi khiến câu trả lời ngắn hơn nhưng bỏ nguồn, hoặc model mới cải thiện một chủ đề nhưng giảm chính xác ở chủ đề khác, nhóm cần quyết định tradeoff minh bạch. Mọi thay đổi cần ghi lý do, reviewer, tập test và kết quả trước khi deploy.
Giám sát sau triển khai
Theo dõi sức khỏe kỹ thuật như uptime, latency, HTTP/API error, timeout, queue và throughput; thêm usage/token/call counts để hiểu tiêu thụ. Theo dõi lớp ứng dụng như tool success, retrieval coverage, câu hỏi không trả lời, citations, user feedback và escalation. Những metric này là tín hiệu vận hành, không đồng nghĩa tự động đo được “mức độ hài lòng” hoặc “độ chính xác” nếu chưa có định nghĩa.
Kiểm tra theo nhóm model, version, kênh, ngôn ngữ và loại tác vụ khi được phép; metric toàn cục có thể che một phân khúc lỗi. Không ghi toàn bộ prompt và dữ liệu cá nhân vào log mặc định. Áp dụng redaction, sampling, hạn lưu, phân quyền và quy trình truy cập trace. Nếu cần dùng dữ liệu người dùng để tạo evaluation set, loại bỏ thông tin không cần và kiểm tra chính sách.
MLflow Tracing là một ví dụ công cụ ghi trace, metrics và hỗ trợ đánh giá; tài liệu mô tả theo dõi latency/token usage và cách đưa trace thực tế vào tập đánh giá. Không bắt buộc dùng MLflow. Chọn cách observability tương thích kiến trúc và chính sách dữ liệu của tổ chức.
Xử lý sự cố và thay đổi
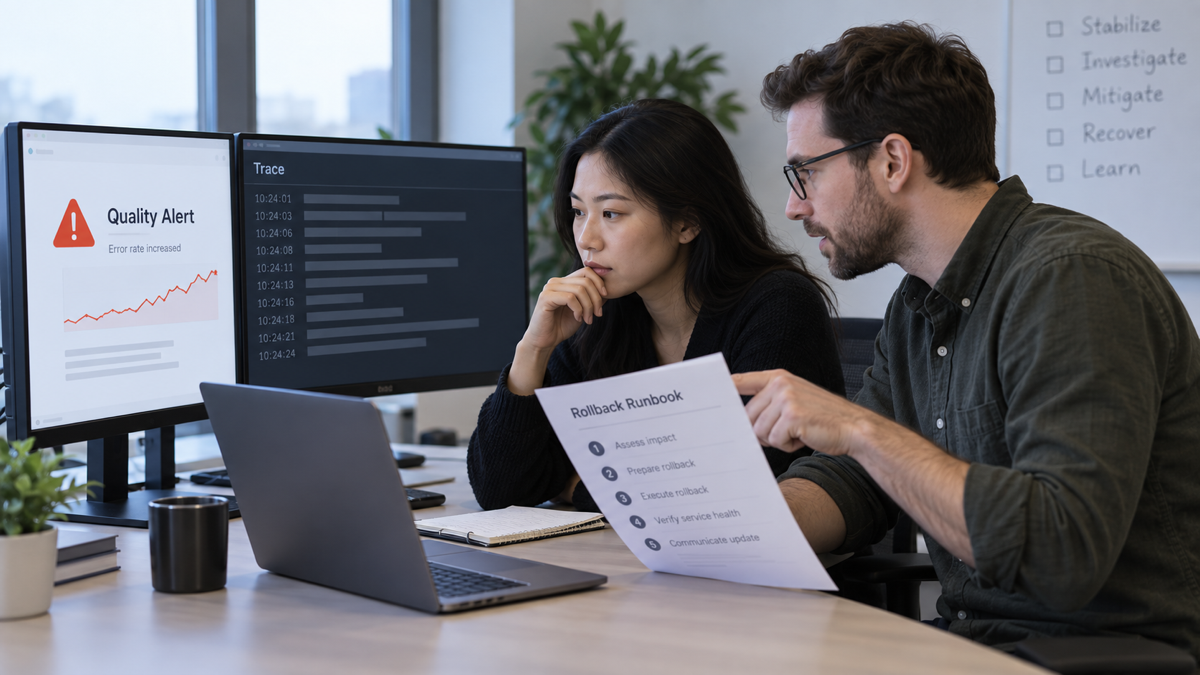
Runbook nên có tình huống và hành động: câu trả lời sai gây ảnh hưởng, dữ liệu nhạy cảm bị lộ, retrieval trả nguồn cũ, tool gọi nhầm, provider gián đoạn, chi phí tăng bất thường hoặc latency vượt ngưỡng. Mỗi loại ghi mức nghiêm trọng, người nhận, cách tắt/giảm chức năng, phương án fallback và cách lưu bằng chứng. Với lỗi an toàn, ưu tiên ngừng bước nguy hiểm hơn là cố phục vụ bằng câu trả lời đoán.
Một thay đổi model/prompt/retrieval cần được xem như release: tạo candidate, chạy eval, xem trace, phê duyệt, deploy có kiểm soát, theo dõi sau phát hành và rollback khi cần. “Model mới hơn” không đảm bảo phù hợp hơn. Nếu đổi nhiều lớp cùng lúc, khó xác định nguyên nhân khi chất lượng đổi; tách thay đổi trong phạm vi có thể kiểm chứng.
Lộ trình triển khai theo quy mô
- Prototype: lưu prompt và config trong version control; tạo tập câu hỏi chuẩn; không đưa dữ liệu production nhạy cảm vào bản thử.
- Staging: có trace redacted, test tự động cho format/tool/retrieval, phê duyệt và checklist release.
- Production: dashboard technical/quality, alert, access control, redaction/retention, feedback, owner và runbook.
- Continuous improvement: biến trace lỗi thành test, đánh giá candidate bằng cùng dataset, kiểm tra drift nguồn và xem lại tiêu chí khi mục tiêu đổi.
Nhóm nhỏ có thể làm từng phần tối thiểu thay vì mua nhiều công cụ trước khi hiểu rủi ro. Hãy bắt đầu với loại lỗi gây tác động lớn nhất: ví dụ, nếu ứng dụng tra chính sách thì sai nguồn và quyền truy cập quan trọng hơn việc tối ưu vài mili giây. Khi lưu lượng tăng, đánh giá sampling, asynchronous logging và retention để tránh làm chậm ứng dụng hoặc lưu quá nhiều dữ liệu.
Thuật ngữ liên quan
- LLMOps: thực hành quản lý vòng đời phát triển và vận hành ứng dụng sử dụng LLM.
- Trace: dấu vết của một lần thực thi, có thể chứa spans cho retrieval, model và tools.
- Evaluation set: tập ví dụ dùng lặp lại để đo hoặc so sánh hành vi ứng dụng.
- Regression: chất lượng hoặc chức năng giảm sau một thay đổi, phát hiện bằng so sánh với baseline.
- Rollback: quay lại cấu hình/phiên bản trước đã biết khi bản phát hành mới gây lỗi, nếu dữ liệu và kiến trúc cho phép.
Câu hỏi thường gặp
LLMOps khác MLOps ở điểm nào?
LLMOps xử lý thêm prompt, context, retrieval, tool calls, đầu ra tự do và đánh giá ngôn ngữ; vẫn dùng các nguyên tắc về version, release, observability và vận hành của MLOps.
Có cần tracing mọi hội thoại?
Không nhất thiết lưu mọi nội dung. Cần đủ dấu vết để điều tra và đánh giá theo mục tiêu, nhưng phải cân bằng quyền riêng tư, retention và chi phí; dùng redaction và sampling khi thích hợp.
LLM judge có thể thay người đánh giá?
Không nên coi điểm judge là chân lý. Hiệu chuẩn judge với review chuyên gia, kiểm tra sai lệch, dùng người cho trường hợp rủi ro cao và theo dõi khi mô hình/tiêu chí thay đổi.
Đưa model mới lên có cần chạy lại eval?
Có. Model/provider hoặc tham số đổi có thể làm chất lượng, latency, format và chi phí thay đổi. Chạy tập regression đại diện và review các case quan trọng trước phát hành.
Làm sao kiểm soát chi phí ứng dụng LLM?
Đo số request, token/call theo luồng, retries, tool use và model/version; đặt budget/alert; kiểm tra prompt dài, lặp call và traffic bất thường. Tối ưu phải giữ chất lượng đạt tiêu chí.
LLMOps có bắt buộc dùng MLflow không?
Không. MLflow là một lựa chọn cho tracking/tracing/evaluation. Tổ chức có thể dùng observability stack khác hoặc tự xây, miễn có phiên bản, kiểm thử, log an toàn, giám sát và quy trình xử lý sự cố phù hợp.

Bình luận (0
)