MLOps đưa machine learning từ thử nghiệm sang hệ thống có thể triển khai và vận hành lặp lại. Quy trình quản lý dữ liệu, mã, cấu hình, thí nghiệm, kiểm thử, phiên bản model, serving và giám sát. Mục tiêu là biết model nào đang chạy, vì sao và khi nào cần dừng hoặc quay lui.
MLOps giải quyết vấn đề gì?
Một notebook đạt điểm tốt trên tập kiểm thử chưa đủ để đảm bảo model hoạt động đáng tin cậy khi phục vụ người dùng. Dữ liệu production có thể khác dữ liệu huấn luyện; thư viện đổi phiên bản; pipeline chạy trên máy khác; model không có API phục vụ; hoặc nhóm không biết kết quả nào được tạo từ mã và tập dữ liệu nào. Khi lỗi xảy ra, thiếu log/metadata khiến điều tra và tái hiện khó khăn.
MLOps áp dụng nguyên tắc kỹ thuật vận hành phần mềm vào hệ thống học máy, đồng thời tính đến vòng đời dữ liệu và model. Tài liệu kiến trúc Google Cloud mô tả MLOps là văn hóa/thực hành kết hợp phát triển và vận hành ML, với tự động hóa và giám sát xuyên suốt tích hợp, kiểm thử, phát hành, triển khai và hạ tầng. Hệ thống thực tế còn có cấu hình, thu thập/xác minh dữ liệu, quản lý tài nguyên, phân tích model, serving và monitoring; model chỉ là một thành phần.
Điều này cũng giúp AI Engineer và nhóm dữ liệu phân định trách nhiệm: ai sở hữu dữ liệu, ai phê duyệt model, ai vận hành endpoint, điều kiện nào kích hoạt huấn luyện lại, ai được phép phát hành và cách rollback ra sao. Bài AI Engineer cần học gì đặt MLOps trong bản đồ kỹ năng rộng hơn; còn các công cụ phát triển AI cho người mới giúp bắt đầu chọn tool theo công đoạn.
Vòng đời một model trong production
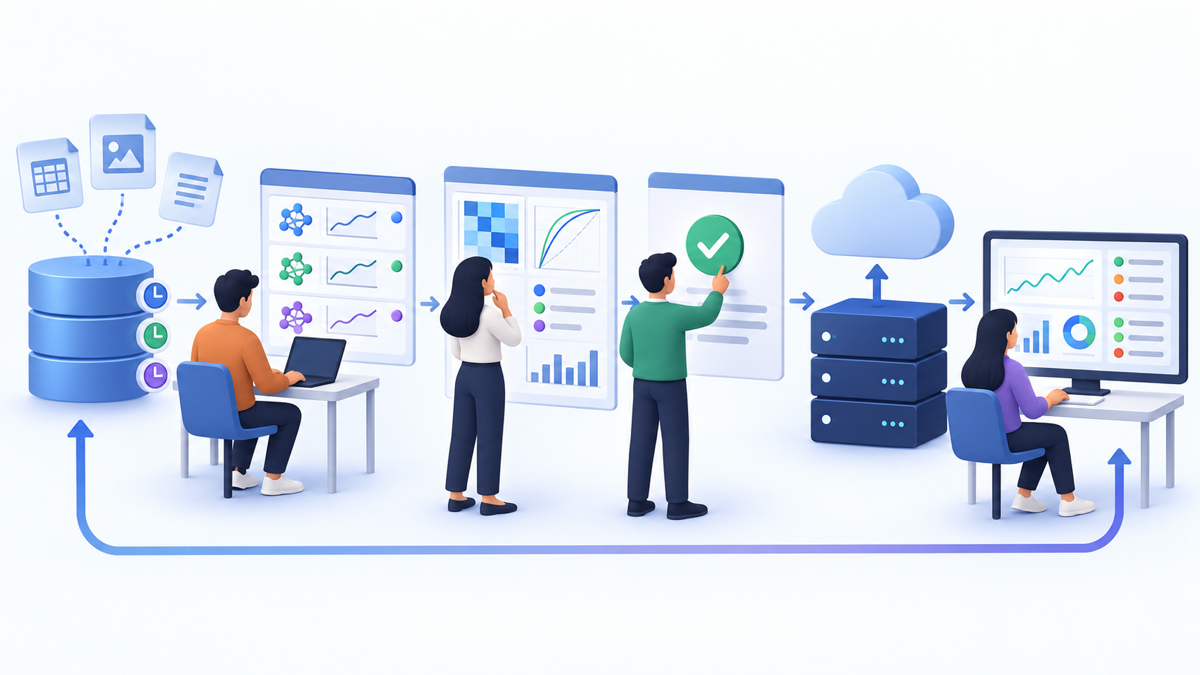
Một luồng cơ bản bắt đầu khi có bài toán và dữ liệu đủ quyền sử dụng. Nhóm định nghĩa target, tạo bộ dữ liệu train/validation/test đúng cách, chuẩn hóa feature, huấn luyện, so sánh model với baseline và ghi lại các tham số, mã nguồn, dữ liệu hoặc phiên bản dữ liệu, metric và artifact. Sau khi kiểm tra, model được đóng gói, chuyển tới môi trường staging, kiểm thử tích hợp và chỉ phát hành khi điều kiện đã đặt trước được đáp ứng.
Khi chạy thật, hệ thống phải ghi nhận request/response cần thiết, lỗi, độ trễ và metric về chất lượng. Nếu model dự báo rủi ro, có thể cần theo dõi phân bố đầu vào hoặc phản hồi nhãn trễ; nếu có cập nhật dữ liệu mới, pipeline huấn luyện lại cần tái chạy kiểm thử chứ không tự động thay model chỉ vì có dữ liệu mới. Mọi bước phải truy nguyên được tới phiên bản cụ thể.
| Giai đoạn | Câu hỏi cần trả lời | Bằng chứng nên lưu |
|---|---|---|
| Định nghĩa bài toán | Model hỗ trợ quyết định nào? Sai số nào nguy hiểm? | Metric nghiệp vụ/kỹ thuật, baseline, phạm vi sử dụng |
| Dữ liệu và feature | Nguồn, quyền, thời điểm và cách xử lý thiếu/trùng? | Data lineage, schema, kiểm tra chất lượng, phiên bản |
| Thí nghiệm | Run nào tạo ra model đang được đề xuất? | Commit, cấu hình, metric, artifact, môi trường |
| Phê duyệt | Model đạt ngưỡng và kiểm tra an toàn chưa? | Test report, reviewer, quyết định phát hành |
| Triển khai | Serving có đủ tài nguyên và hợp đồng API ổn định? | Container/package, config, model version, release record |
| Vận hành | Độ trễ, lỗi, drift và chất lượng có thay đổi? | Metrics, alert, feedback, incident, rollback log |
CI, CD và CT trong ML
Continuous Integration (CI) tự kiểm tra thay đổi mã như lint, unit test, schema validation và build package. Với ML, kiểm tra có thể bao gồm feature transformation, tái lập pipeline và đánh giá model theo ngưỡng đã định. Continuous Delivery/Deployment (CD) đưa artifact đã được duyệt qua staging hoặc production theo chiến lược phát hành của nhóm. CD không có nghĩa mọi model mới tự động được phục vụ người dùng.
Continuous Training (CT) tự động chạy lại quy trình huấn luyện khi điều kiện được xác định, chẳng hạn lịch, dữ liệu mới đã được kiểm tra hoặc sự kiện vận hành. CT không đồng nghĩa “có dữ liệu mới là thay model”. Một candidate phải qua kiểm tra data quality, đánh giá trên tập validation/holdout phù hợp, so sánh với model hiện tại, và bước phê duyệt theo mức rủi ro. Nếu nhãn đến trễ hoặc có seasonal pattern, trigger đơn giản có thể khiến nhóm huấn luyện trên dữ liệu chưa hoàn chỉnh.
Kiến trúc và mức tự động hóa nên phản ánh quy mô, tốc độ thay đổi dữ liệu và rủi ro ứng dụng. Team nhỏ có thể bắt đầu bằng script có version control, lưu run và deploy thủ công có checklist. Khi số thí nghiệm, người dùng và tần suất phát hành tăng, đầu tư pipeline, registry, CI/CD và monitoring. Tự động hóa một quy trình chưa ổn định chỉ làm sai lầm lặp nhanh hơn.
Ví dụ: dự báo nhu cầu cửa hàng
Giả sử nhóm dự báo số lượng sản phẩm cần chuẩn bị cho từng cửa hàng. Họ xác định horizon dự báo, nhóm sản phẩm và metric phù hợp; lưu ý sai số thiếu hàng và dư hàng có chi phí khác nhau. Pipeline lấy dữ liệu bán hàng, kiểm tra ngày thiếu, schema, dữ liệu tương lai rò vào tập huấn luyện và thay đổi mapping cửa hàng. Một baseline đơn giản được ghi lại trước khi so với model phức tạp.
Mỗi run lưu commit, khoảng dữ liệu, feature version, tham số và metric. Candidate chỉ được đưa vào staging nếu vượt baseline theo tiêu chí đã đồng thuận và qua kiểm tra cho nhóm cửa hàng được đánh giá. Người phụ trách kiểm tra output, latency, cấu trúc API và fallback. Khi phát hành, có thể bắt đầu bằng một phần lưu lượng hoặc chỉ chạy shadow prediction để so sánh mà chưa dùng kết quả cho quyết định vận hành.
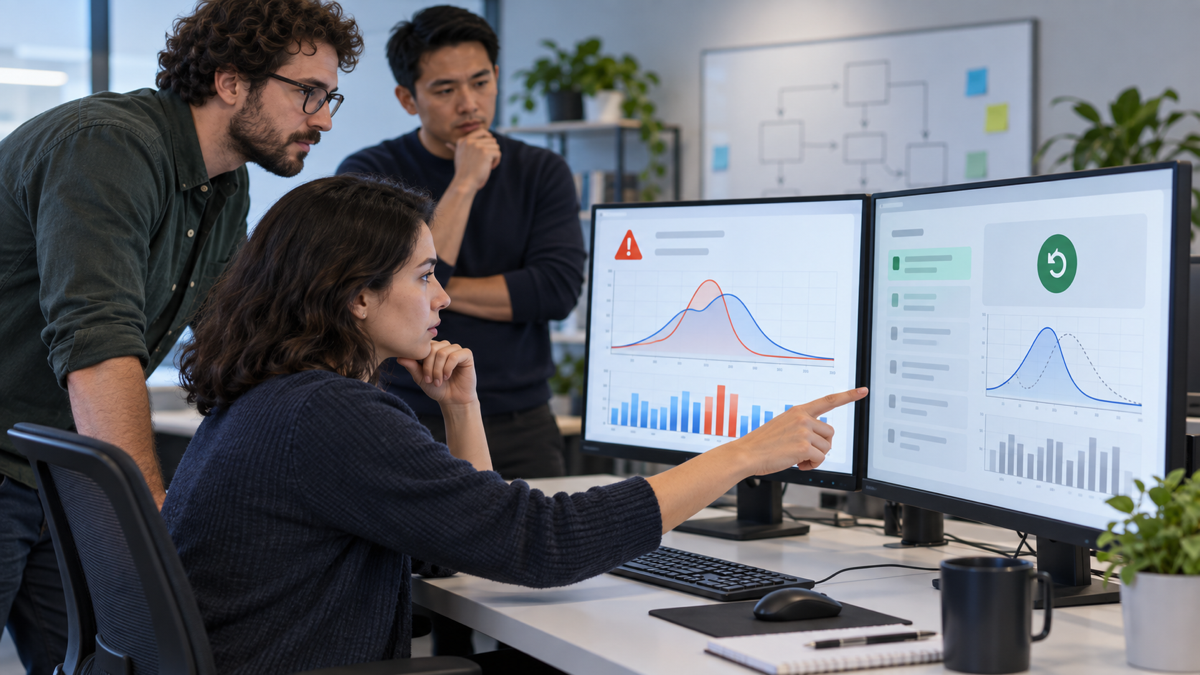
Vài tuần sau, một cửa hàng chuyển địa điểm khiến phân bố dữ liệu đổi. Dashboard báo tỷ lệ thiếu feature tăng; alert tạo ticket cho nhóm dữ liệu. Họ kiểm tra nguyên nhân, xác nhận ngày mapping bị đổi, rồi chọn một trong ba hành động: sửa pipeline và đánh giá lại, tạm dùng fallback đã xác nhận, hoặc rollback model. Không nên âm thầm huấn luyện lại trên dữ liệu sai rồi ghi đè phiên bản đang hoạt động.
Các thành phần và dấu vết cần quản lý
- Version control: mã pipeline, cấu hình, schema và tài liệu thay đổi; secret không lưu trực tiếp trong repository.
- Data validation: kiểm tra schema, kiểu dữ liệu, missingness, khoảng giá trị, duplicate và nguồn; xử lý sai lệch theo quy tắc thay vì tự động xóa.
- Experiment tracking: ghi tham số, metric, code version, input/dataset và artifact để so sánh các run.
- Model registry: quản lý tên, phiên bản, metadata, stage/approval và artifact model; phải biết quy trình promote/rollback của nền tảng đang dùng.
- Pipeline/orchestrator: kết nối ingest, validation, training, evaluation, packaging và release; mỗi bước cần trạng thái, log và cách xử lý lỗi.
- Serving: endpoint, batch scoring hoặc embedded inference; theo dõi hợp đồng đầu vào/đầu ra, latency, capacity và fallback.
- Monitoring: đo sức khỏe hệ thống và chất lượng model; quy định ai nhận alert, severity, runbook và điều kiện ngừng.
MLflow Tracking là ví dụ công cụ ghi parameters, code versions, metrics và artifacts của run để xem lại; đây là lựa chọn cụ thể chứ không phải yêu cầu duy nhất của MLOps. Việc dùng registry, tracking server hay dịch vụ managed cần xét tích hợp, quyền truy cập, lưu trữ artifact, chi phí và cách vận hành tại tổ chức.
Giám sát và xử lý khi chất lượng giảm
Monitoring có ít nhất hai lớp. Lớp hệ thống theo dõi request, lỗi, tài nguyên, latency và availability. Lớp ML theo dõi phân bố feature, output, nhãn thật khi có, metric theo thời gian, phân khúc và tác động nghiệp vụ. Model không nhất thiết sai chỉ vì một phân bố thay đổi; alert là tín hiệu điều tra chứ không phải lệnh tự động phát hành phiên bản mới.
Đặt ngưỡng dựa trên baseline và yêu cầu ứng dụng, ghi ai nhận cảnh báo và hành động an toàn kế tiếp. Với phản hồi/nhãn đến trễ, tránh tính metric như thể nhãn đã đầy đủ. Với model phục vụ nhiều nhóm, tổng metric tốt có thể che lỗi ở một phân khúc. Cần đánh giá công bằng và quyền riêng tư phù hợp với use case; dữ liệu log nên được giới hạn tối thiểu cần thiết.
Lộ trình xây MLOps theo quy mô
- Đảm bảo tái lập: pin môi trường cần thiết, version hóa mã/config, lưu dữ liệu/feature lineage và metric của từng run.
- Đưa kiểm tra thành bước tự động: unit tests, schema checks, data validation và model evaluation chạy khi có thay đổi.
- Chuẩn hóa artifact: đóng gói inference và ghi rõ model, runtime, dependencies, API contract.
- Thiết lập phát hành có kiểm soát: staging, checklist/phê duyệt, canary/shadow phù hợp, rollback có thể thực hiện.
- Thêm monitoring và phản hồi: alert, dashboard, feedback data và quy trình điều tra/đóng sự cố.
- Chỉ sau đó tự động CT: trigger rõ ràng, candidate validation, approval policy và điều kiện không promote.
Nếu là người học, hãy làm project nhỏ nhưng có dấu vết từ đầu đến cuối: train một baseline, log run, viết test dữ liệu, đóng gói model, triển khai local/staging và tạo dashboard hoặc runbook minh họa. Không cần bắt đầu bằng một hệ thống phân tán phức tạp. Việc trình bày được model tái tạo ra sao, phát hành thế nào và khi lỗi sẽ xử lý gì thường có giá trị học tập hơn danh sách tool dài.
Thuật ngữ liên quan
- CI: tự kiểm tra thay đổi mã/cấu hình để phát hiện lỗi sớm trước khi hợp nhất hoặc phát hành.
- CD: quy trình đưa artifact qua môi trường kiểm thử và triển khai theo điều kiện đã đặt.
- CT: huấn luyện lại theo trigger, sau đó vẫn cần kiểm tra và quyết định promote.
- Model drift: thay đổi trong dữ liệu hoặc quan hệ dự báo theo thời gian; cần xác định loại drift và tác động thay vì chỉ dựa vào một cảnh báo.
- Lineage: dấu vết liên kết model với nguồn dữ liệu, mã, cấu hình, run và lần triển khai.
Câu hỏi thường gặp
MLOps có giống DevOps không?
MLOps kế thừa thực hành DevOps nhưng bổ sung các vấn đề đặc thù ML như dữ liệu, feature, thí nghiệm, model artifact, drift và đánh giá chất lượng dự báo. Mức độ áp dụng tùy hệ thống.
AI Engineer có cần biết MLOps không?
Nên hiểu nguyên tắc version hóa, tái lập, triển khai và giám sát nếu làm model hướng production. Mức chuyên sâu phụ thuộc vai trò; không phải vị trí nào cũng phải tự quản toàn bộ hạ tầng.
MLOps có bắt buộc dùng Kubernetes?
Không. Kubernetes có thể hữu ích ở một số kiến trúc nhưng không phải điều kiện định nghĩa MLOps. Chọn cách serving theo tải, đội ngũ, độ tin cậy và khả năng vận hành.
MLflow có phải công cụ MLOps duy nhất?
Không. MLflow cung cấp tracking và các khả năng quản lý model, nhưng hệ thống có thể dùng công cụ khác hoặc dịch vụ nền tảng. Ưu tiên khả năng truy nguyên, tích hợp, bảo mật và quy trình của nhóm.
Khi nào nên huấn luyện lại model?
Khi có tín hiệu và tiêu chí được xác định, chẳng hạn dữ liệu mới đủ chất lượng, chất lượng giảm có ý nghĩa hoặc yêu cầu sản phẩm đổi. Huấn luyện lại tạo candidate; chỉ phát hành sau đánh giá và phê duyệt phù hợp.
Model accuracy giảm thì rollback có đủ không?
Rollback có thể khôi phục phiên bản trước nếu đó là phương án an toàn, nhưng vẫn cần tìm nguyên nhân dữ liệu, serving hoặc thay đổi nghiệp vụ. Kiểm tra tác động và thông báo cho người phụ trách trước khi quyết định.

Bình luận (0
)