Thiếu phương án nên chưa thể chọn đáp án “được nhắc đến”; cũng không có OCR tốt nhất cho mọi tài liệu. Tesseract là engine mã nguồn mở chạy cục bộ; Google Document AI là dịch vụ xử lý tài liệu trên cloud. Hãy thử bằng tài liệu thật và kiểm tra kết quả.
Câu hỏi thiếu phương án trả lời
Câu hỏi “phần mềm nào sau đây là một trong những giải pháp OCR hàng đầu được nhắc đến” có dạng trắc nghiệm nhưng không kèm danh sách lựa chọn hoặc nguồn “được nhắc đến”. Vì vậy không thể chọn một phương án đúng một cách có căn cứ. Đây là câu hỏi khác với “phần mềm OCR nào phù hợp với công việc của tôi”: câu thứ hai cần thông tin về tài liệu, ngôn ngữ, khối lượng, bảo mật và hệ thống đang dùng.
Nếu cần nêu ví dụ để hiểu nhóm công cụ, có Tesseract, một engine nhận dạng văn bản mã nguồn mở, và các dịch vụ xử lý tài liệu trên đám mây như Google Document AI. Hai ví dụ có mô hình triển khai khác nhau; không nên biến chúng thành thứ hạng, cũng không thể khẳng định dịch vụ nào chính xác hơn nếu chưa thử cùng bộ dữ liệu. Việc “được nhắc đến” trong một tài liệu cụ thể chỉ có thể xác nhận khi có tài liệu đó hoặc các phương án đầy đủ.
Người đang soạn câu hỏi quiz nên đưa đủ lựa chọn và nguồn tham chiếu; người tìm công cụ nên đổi câu hỏi thành “công cụ nào đáp ứng tiêu chí của tài liệu X”. Bài các công cụ phát triển AI cho người mới nói về hệ sinh thái công cụ rộng hơn, còn nội dung này tập trung OCR và xử lý tài liệu.
OCR làm gì và không làm gì?
OCR (Optical Character Recognition) nhận dạng ký tự trong ảnh hoặc trang đã quét và chuyển chúng thành văn bản có thể tìm kiếm, sao chép hoặc xử lý tiếp. Một hệ thống nâng cao có thể trả về tọa độ, cấu trúc trang, bảng hoặc trường dữ liệu, nhưng những khả năng đó phụ thuộc vào công cụ và loại processor được chọn. Một tệp PDF có thể đã chứa văn bản chọn được; trường hợp đó cần trích xuất văn bản chứ không nhất thiết chạy OCR.
OCR không tự xác nhận nội dung nhìn thấy là đúng. Nếu bản gốc mờ, chữ viết tay khó đọc, trang lệch, con dấu đè lên số, hoặc bảng bị chia cột phức tạp, kết quả có thể sai mà trông vẫn hợp lý. Cũng cần phân biệt nhận dạng chữ với trích xuất thông tin: OCR có thể đọc “Tổng cộng 1.250.000”, nhưng hệ thống tiếp theo mới quyết định đây là trường tổng tiền, số tiền trước thuế hay một con số ở ghi chú.
Chọn theo loại tài liệu
Bắt đầu bằng cách nhóm tài liệu theo mẫu và mục đích, không theo đuôi file. Ví dụ “hóa đơn PDF” có thể gồm PDF điện tử với lớp chữ, bản scan rõ một trang, ảnh chụp điện thoại có bóng và hóa đơn nhiều trang của nhà cung cấp nước ngoài. Mỗi nhóm tạo điều kiện nhận dạng khác nhau. Hãy kiểm tra ngôn ngữ, chất lượng ảnh, hướng chữ, bảng, checkbox, chữ viết tay và trường nào bắt buộc.
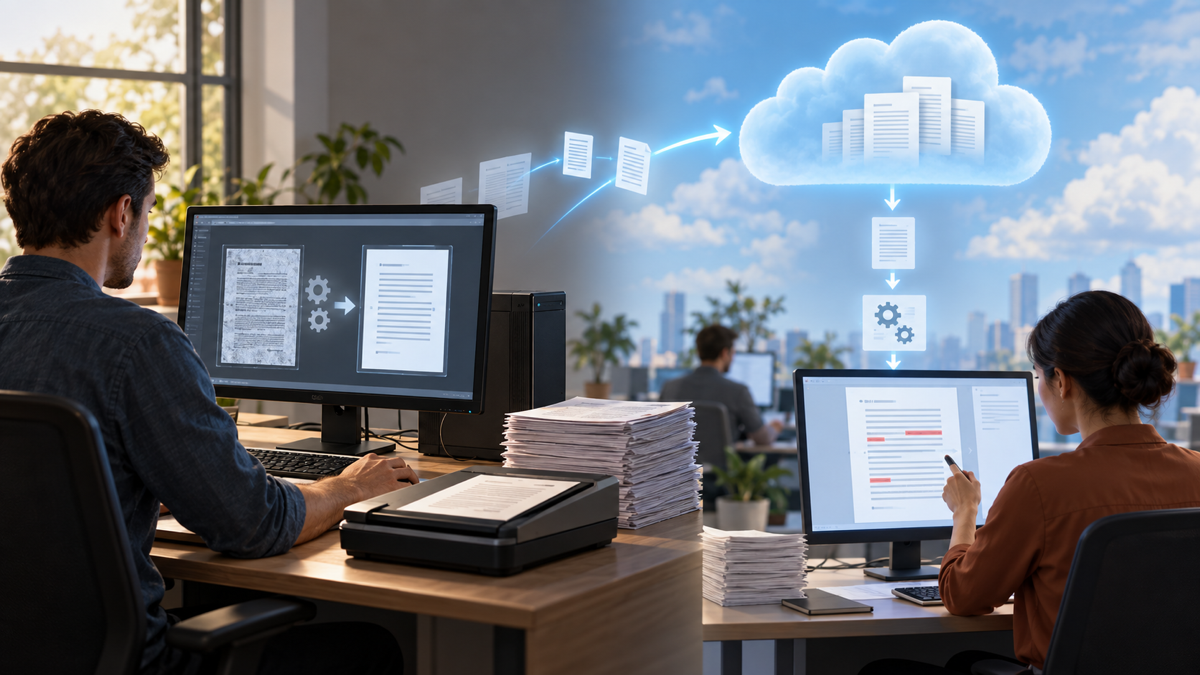
Nếu chỉ cần tìm kiếm trong kho ảnh tài liệu, lấy văn bản và vị trí chữ có thể đủ. Nếu cần đẩy số hóa đơn, ngày, mã số thuế và tổng tiền sang kế toán, OCR đơn thuần có thể chưa cung cấp đúng trường. Cần bộ phân tích biểu mẫu hoặc extractor, quy tắc xác thực, và người duyệt ngoại lệ. Google Document AI phân biệt khả năng OCR với các bộ xử lý dùng để trích xuất form, bảng hay thực thể; tên sản phẩm cụ thể và tính khả dụng cần xem trong tài liệu cập nhật trước khi thiết kế.
| Nhu cầu | Kiểu giải pháp cần xem xét | Điểm cần thử |
|---|---|---|
| Đọc chữ in từ ảnh rời, xử lý tại máy | OCR engine cục bộ như Tesseract | Ngôn ngữ cần dùng, định dạng đầu vào, bố cục, năng lực vận hành |
| Đọc nhiều loại hồ sơ và trích xuất trường | Nền tảng xử lý tài liệu/Document AI | Processor, trường cần lấy, cấu trúc phản hồi, giới hạn tệp, vùng dữ liệu |
| PDF điện tử có lớp text | Trích xuất text trực tiếp trước khi OCR | Văn bản có đúng thứ tự đọc và bảng có giữ cấu trúc không |
| Chữ viết tay, ảnh điện thoại hoặc biểu mẫu đặc thù | Thử các hệ thống trên tập mẫu đại diện, có thể cần xử lý ảnh/human review | Tỷ lệ lỗi ở đúng trường quan trọng, không chỉ điểm tổng thể |
| Dữ liệu nhạy cảm hoặc không được phép tải lên dịch vụ ngoài | Giải pháp cục bộ hoặc môi trường đã được tổ chức phê duyệt | Luồng lưu, quyền truy cập, logging, retention, hợp đồng và chính sách |
So sánh các lựa chọn đại diện
Bảng dưới đây chỉ so sánh mô hình lựa chọn và đặc điểm được nhà cung cấp/dự án công bố, không xếp hạng độ chính xác. Thông số hỗ trợ, giới hạn ngôn ngữ, định dạng và chính sách xử lý dữ liệu có thể thay đổi; kiểm tra trang tài liệu hiện hành trước khi triển khai.
| Lựa chọn | Đặc điểm có thể kiểm chứng | Phù hợp để khảo sát khi | Câu hỏi trước triển khai |
|---|---|---|---|
| Tesseract | Engine OCR mã nguồn mở; có tài liệu ngôn ngữ và cách chạy qua command line/API | Muốn thử xử lý cục bộ, đầu vào chủ yếu là ảnh văn bản in | Đã cài dữ liệu ngôn ngữ chưa? Có cần tự xây lớp nhận dạng bảng/biểu mẫu không? |
| Google Document AI | Nền tảng tài liệu trên cloud, có OCR và các loại processor cho tác vụ cấu trúc | Quy trình cần trả về text/layout hoặc trường tài liệu theo nhu cầu | Processor nào đúng use case? Khu vực xử lý, quyền IAM, lưu trữ và quota ra sao? |
| Trích xuất text PDF | Đọc lớp văn bản sẵn có thay vì nhận dạng pixel | PDF được tạo số, có thể chọn và sao chép chữ | Văn bản có bị mã hóa font, đảo thứ tự cột hoặc thiếu nội dung scan không? |
Không suy ra “mã nguồn mở” đồng nghĩa hoàn toàn miễn phí trong mọi tình huống: vận hành, tích hợp, bảo trì, kiểm thử và hạ tầng vẫn có công sức hoặc chi phí. Tương tự, dùng dịch vụ cloud không đồng nghĩa luôn dễ hơn; đội ngũ vẫn phải thiết lập quyền, xử lý lỗi, quản lý dữ liệu và kiểm tra hóa đơn theo cách tính hiện hành. Bài này không nêu giá vì chi phí phụ thuộc lựa chọn dịch vụ, vùng, khối lượng và thời điểm.
Cách thử OCR bằng dữ liệu của bạn
- Lấy mẫu có chủ đích: chọn tài liệu rõ, mờ, lệch, nhiều cột, nhiều trang, nhiều ngôn ngữ và các ngoại lệ thường gặp. Không chỉ lấy ảnh đẹp nhất.
- Tạo đáp án chuẩn: người có chuyên môn gõ lại văn bản/trường cần lấy và thống nhất cách xử lý dấu câu, số, ngày. Giữ bản gốc để đối chiếu.
- Đặt thước đo theo rủi ro: lỗi một ký tự trong đoạn văn có thể chấp nhận được nhưng lỗi một chữ số ở số tài khoản hoặc tổng tiền có thể không. Đo riêng các trường quan trọng.
- Chạy cùng tập mẫu: dùng cùng tài liệu, cùng điều kiện tiền xử lý, ghi tên công cụ/cấu hình, ngày thử, thời gian xử lý và lỗi.
- Kiểm tra quy trình sau OCR: xác minh ai sửa ngoại lệ, dữ liệu sai đi đâu, có lưu ảnh gốc và nhật ký biến đổi không.
- Thử điều kiện dữ liệu thật: kiểm tra quyền, khả năng xử lý tại vùng được phép, giới hạn API, đường truyền và tình huống dịch vụ gián đoạn.
Để tính lỗi ký tự, có thể so chuỗi OCR với bản chuẩn sau khi thống nhất quy tắc chuẩn hóa; tuy vậy, điểm tổng không thay thế việc kiểm tra trường nghiệp vụ. Với hóa đơn, cần đo đúng số tiền, mã số, ngày và đơn vị tiền tệ. Hãy ghi nhận cả trường hợp OCR tự bỏ nội dung và trường hợp đưa ra ký tự sai, vì hai loại lỗi cần cách sửa khác nhau.
Ví dụ: số tiền trên hóa đơn
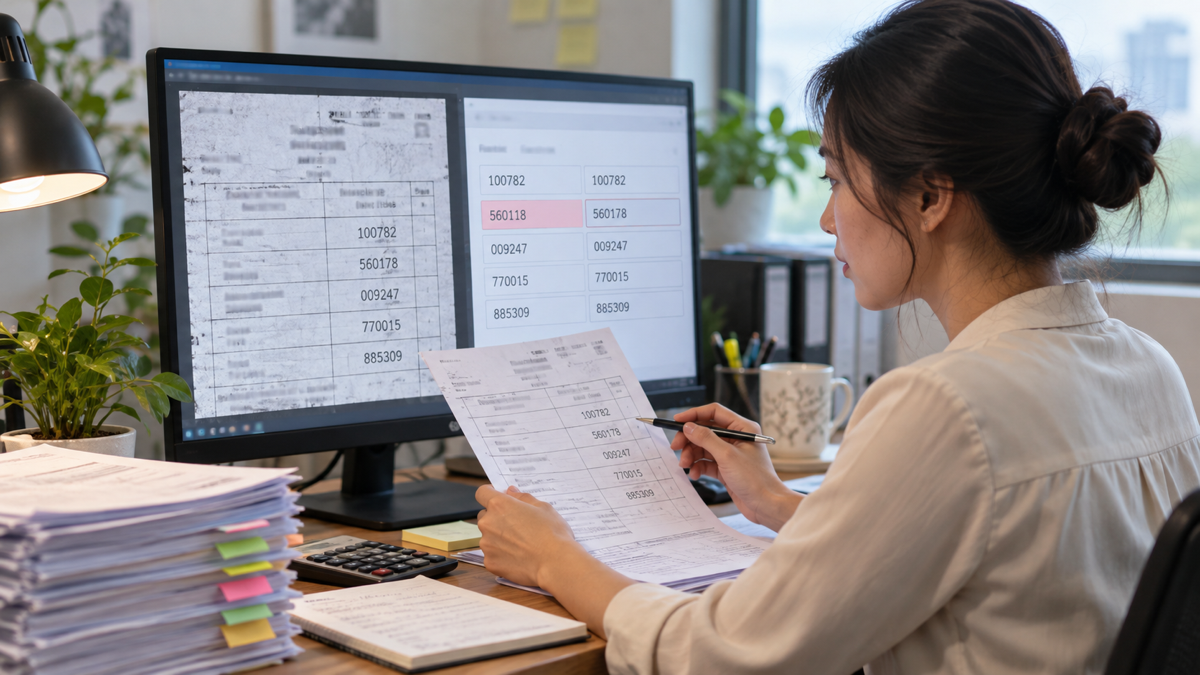
Giả sử một nhóm nhập hóa đơn nhà cung cấp. Bản scan có dòng “Tổng thanh toán 1.250.000”, nhưng OCR trả “1.25O.OOO” do nhầm số 0 với chữ O. Nếu quy trình chuyển thẳng chuỗi sang hệ thống kế toán, dữ liệu có thể bị loại hoặc diễn giải sai. Thiết kế an toàn là giữ giá trị OCR thô, áp dụng kiểm tra định dạng số và hiển thị ảnh vùng tương ứng cho người duyệt khi ký tự mơ hồ.
Không nên tự “sửa” thành 1.250.000 chỉ vì con số có vẻ hợp lý. Nếu tổng tiền khớp một phép tính khác, vẫn cần đối chiếu bản scan và quy tắc nghiệp vụ. Cũng không được tự suy ra ngày hóa đơn từ ngày email nhận. Giá trị không đọc được phải mang trạng thái chưa xác minh, chứ không thay bằng giá trị đoán.
| Trường | Đầu ra OCR thô | Kiểm tra tiếp | Khi nào cần người |
|---|---|---|---|
| Số hóa đơn | “HD-O12” | So mẫu ký tự với ảnh và định dạng nhà cung cấp | O/0 không phân biệt được |
| Ngày | “03/04/2026” | Xác định định dạng ngày đã thỏa thuận | Không rõ ngày/tháng hay tháng/ngày |
| Tổng thanh toán | “1.25O.OOO” | Kiểm tra ký tự số, dấu phân tách, tiền tệ | OCR không đọc chắc hoặc lệch với chứng từ |
| Mã số thuế | Thiếu một chữ số | Đối chiếu ảnh và nguồn xác thực được phép | Không được tự bổ sung từ hồ sơ khác nếu chưa có quy tắc |
Thuật ngữ liên quan
- OCR: nhận dạng chữ từ ảnh hoặc trang raster; đầu ra là văn bản/mảnh ký tự và có thể kèm vị trí tùy công cụ.
- Document AI: nhóm công nghệ xử lý tài liệu nhằm chuyển nội dung không cấu trúc thành dữ liệu có thể sử dụng; tên gọi sản phẩm có thể thuộc nhà cung cấp cụ thể.
- Layout: cách chữ, đoạn, cột, bảng và hình được bố trí trên trang; mất layout có thể làm văn bản trích xuất sai thứ tự.
- Ground truth (đáp án chuẩn): bản người kiểm tra xác nhận từ tài liệu gốc, dùng để đánh giá kết quả OCR.
- Human review: bước con người xem ảnh/đầu ra và sửa hoặc xác nhận trường quan trọng.
Câu hỏi thường gặp
Trong câu quiz không có lựa chọn thì có thể khẳng định phần mềm nào?
Không. Thiếu phương án và nguồn được nhắc tới nên không thể chọn đáp án duy nhất. Có thể đưa ví dụ OCR như Tesseract hoặc Google Document AI để minh họa nhóm công cụ, nhưng đó không xác nhận đáp án của câu trắc nghiệm.
Tesseract có phù hợp với tiếng Việt không?
Tài liệu dự án nêu hỗ trợ nhiều ngôn ngữ và có dữ liệu huấn luyện riêng. Trước khi dùng, kiểm tra gói ngôn ngữ hiện có và thử trên văn bản tiếng Việt thực tế, đặc biệt dấu thanh, bảng biểu và chất lượng ảnh.
OCR có đọc được chữ viết tay không?
Khả năng phụ thuộc công cụ, ngôn ngữ, kiểu chữ và chất lượng ảnh. Không nên mặc định engine OCR chữ in sẽ đọc tốt chữ viết tay; hãy tạo tập kiểm thử riêng và có người xác nhận trường quan trọng.
PDF có cần OCR không?
Không phải lúc nào cũng cần. Nếu chọn được chữ trong PDF, thử trích xuất lớp text trước. Nếu PDF là ảnh quét hoặc lớp text hỏng/không có, mới cân nhắc OCR và đối chiếu thứ tự đọc.
Có thể đưa kết quả OCR thẳng vào cơ sở dữ liệu không?
Chỉ khi trường, quy tắc kiểm tra và mức tin cậy đã được đánh giá cho đúng use case. Dữ liệu tài chính, định danh hoặc pháp lý nên có validation và hàng chờ người duyệt cho giá trị thiếu/mơ hồ.
Làm sao so sánh hai phần mềm OCR công bằng?
Dùng cùng tập tài liệu đại diện, cùng đáp án chuẩn, cùng tiền xử lý và đo lỗi theo từng trường. Ghi cấu hình, ngày chạy, thời gian, giới hạn dữ liệu và công sức sửa; không dựa vào ảnh demo do nhà cung cấp chọn.
Nguồn tham khảo
- Google Cloud: Enterprise Document OCR
- Google Cloud: Document AI overview và processor
- Tesseract OCR documentation
- Tesseract: định dạng ảnh/PDF hỗ trợ
- FUNiX: công cụ phát triển AI cho người mới bắt đầu

Bình luận (0
)