Học cấu trúc dữ liệu giúp chọn cách lưu và truy cập thông tin phù hợp với thao tác chính. Danh sách, tập hợp, map, hàng đợi, cây và đồ thị đánh đổi khác nhau về thời gian, bộ nhớ và độ phức tạp. Hiểu chúng giúp code rõ hơn, tránh điểm nghẽn và giải thích lựa chọn kỹ thuật.
Cấu trúc dữ liệu là gì?
Cấu trúc dữ liệu là cách tổ chức giá trị để chương trình lưu, tìm, thêm, xóa hoặc duyệt chúng. Một mảng giữ phần tử theo thứ tự; map gắn khóa với giá trị; queue phục vụ theo thứ tự vào trước ra trước; cây biểu diễn quan hệ phân cấp; đồ thị biểu diễn liên kết tổng quát. Đây không chỉ là định nghĩa trong môn học: bạn đang chọn cấu trúc dữ liệu mỗi khi quyết định dùng một collection, bảng chỉ mục hay hàng đợi tác vụ.
Thuật toán là các bước giải quyết vấn đề; cấu trúc dữ liệu quyết định cách biểu diễn đầu vào và trạng thái để những bước đó hiệu quả. Hai chương trình có cùng kết quả nhưng có thể khác rất nhiều về thời gian chạy, bộ nhớ và mức dễ hiểu vì chọn cách lưu khác nhau.
Thao tác và chi phí
Không có cấu trúc “nhanh nhất” trong mọi trường hợp. Một list thuận tiện để duyệt tuần tự và giữ thứ tự, nhưng tìm một phần tử theo giá trị thường cần kiểm tra nhiều phần tử nếu không có chỉ mục. Hash map thường phù hợp tra cứu theo khóa, nhưng cần bộ nhớ cho bảng băm và không mặc nhiên giữ thứ tự nghiệp vụ. Big O mô tả tốc độ tăng của chi phí khi dữ liệu lớn lên, không dự đoán chính xác thời gian trên máy cụ thể. Kích thước đầu vào, cách cài đặt, cache, runtime và mẫu truy vấn đều quan trọng.
Vì sao lập trình viên cần học?
Hiệu năng: chọn cấu trúc phù hợp tránh công việc lặp dư. Nếu với mỗi đơn hàng bạn duyệt lại toàn bộ khách hàng để tìm ID, chi phí có thể tăng gần theo tích hai số lượng. Một map tra cứu theo ID cho phép tổ chức phép tìm kiếm khác, dù vẫn phải cân nhắc bộ nhớ và cách xử lý khóa trùng.
Độ đúng: cấu trúc thể hiện ràng buộc. Set biểu đạt “mỗi phần tử duy nhất”; queue biểu đạt “xử lý theo thứ tự”; stack biểu đạt “quay lại phần tử gần nhất”. Dùng collection phù hợp giảm điều kiện tự quản lý và lỗi trạng thái.
Khả năng bảo trì: khi code dùng cấu trúc có ý nghĩa, người đọc hiểu ý định mà không cần suy ngược từ nhiều cờ. Cây thư mục hợp với phân cấp; đồ thị hợp với quan hệ có nhiều nhánh. Cách biểu diễn rõ giúp kiểm thử và mở rộng.
Phỏng vấn và đọc hệ thống: nền tảng giúp bạn phân tích câu hỏi thuật toán, hiểu chỉ mục cơ sở dữ liệu, cache, bộ lập lịch, trình phân tích cú pháp và nhiều thành phần thực tế. Mục tiêu không phải thuộc lòng mọi thuật toán mà là dự đoán đánh đổi, xác định ràng buộc và đo khi cần.
So sánh cấu trúc theo thao tác
| Cấu trúc | Biểu diễn | Hợp với | Điểm cần cân nhắc | Ví dụ ứng dụng |
|---|---|---|---|---|
| Array/List | Dãy có thứ tự, truy cập theo vị trí | Duyệt tuần tự, giữ thứ tự, truy cập chỉ số | Chèn/xóa giữa dãy có thể phải dịch phần tử; tìm theo giá trị thường phải quét | Danh sách bài viết, dòng hiển thị |
| Set | Tập phần tử duy nhất | Khử trùng, kiểm tra đã tồn tại | Không dùng khi cần nhiều lần xuất hiện hoặc thứ tự cụ thể chưa được bảo đảm | ID đã xử lý, tag không trùng |
| Map/Dictionary | Ánh xạ khóa sang giá trị | Tra cứu theo khóa, đếm, nhóm | Khóa cần ổn định; xử lý va chạm và bộ nhớ tùy cài đặt | Tra hồ sơ theo mã, đếm từ |
| Queue | Hàng đợi vào trước ra trước | Lập lịch, xử lý việc theo thứ tự, BFS | Phải có chính sách giới hạn, retry và việc lỗi nếu dùng cho tác vụ bền vững | Job chờ, tin nhắn |
| Stack | Vào sau ra trước | Undo, gọi hàm, duyệt DFS | Không phù hợp truy cập ngẫu nhiên tùy ý | Lịch sử thao tác, dấu ngoặc |
| Tree | Nút cha-con theo tầng | Phân cấp, tìm kiếm có thứ tự, cú pháp | Cân bằng và cách lưu quyết định độ sâu/hiệu năng | DOM, danh mục, AST |
| Graph | Đỉnh và cạnh biểu diễn liên kết | Đường đi, quan hệ nhiều-nhiều, phụ thuộc | Biểu diễn cạnh có thể tốn bộ nhớ; cần xử lý chu trình | Bản đồ, mạng xã hội, dependency |
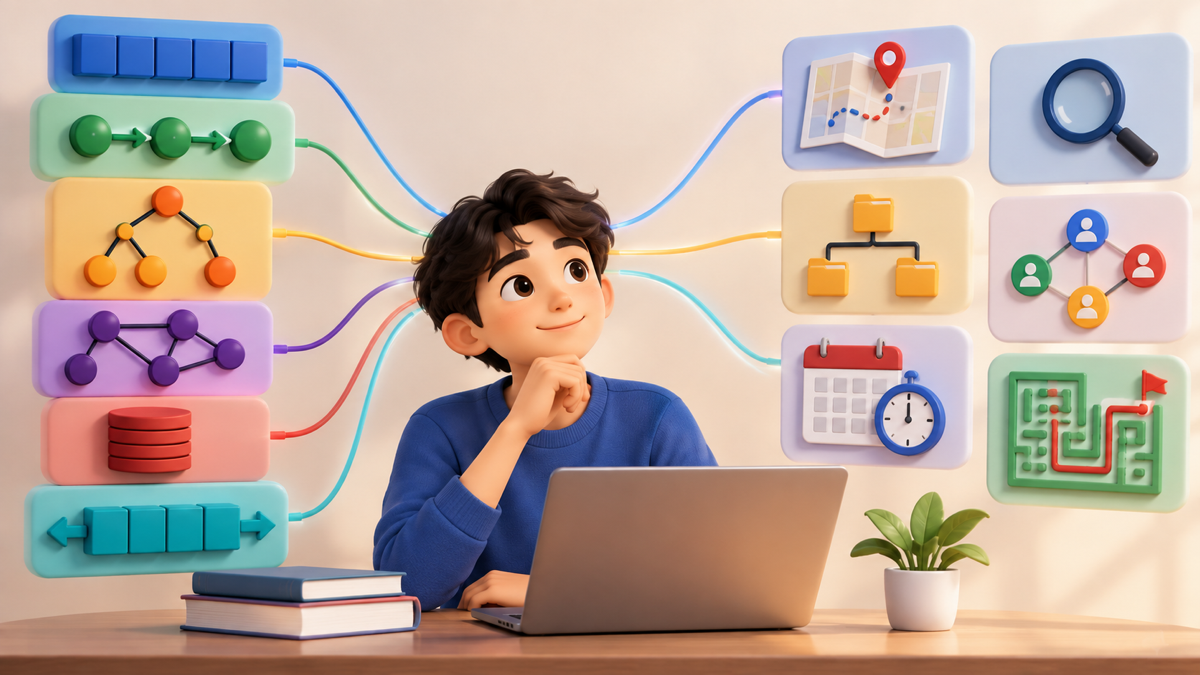
Bảng chỉ nêu trực giác, không thay tài liệu ngôn ngữ cụ thể. Ví dụ, list trong một runtime có thể là mảng động; cấu trúc có cùng tên trong thư viện khác có thể có đặc tính khác. Khi hiệu năng quan trọng, xem tài liệu triển khai đang dùng và đo trên dữ liệu gần thực tế.
Cách chọn theo bài toán
- Viết ra thao tác thường gặp: đọc tuần tự, tìm theo khóa, thêm cuối, xóa giữa, truy vấn đường đi hay lấy phần tử ưu tiên?
- Nêu bất biến: thứ tự có quan trọng không, có khóa duy nhất không, một phần tử có thể xuất hiện lặp, quan hệ có chu trình không?
- Ước lượng quy mô: số phần tử tối đa, tốc độ cập nhật, giới hạn bộ nhớ và tần suất truy cập.
- Chọn mô hình dễ diễn đạt: chọn cấu trúc thể hiện nghiệp vụ trước; tối ưu sớm bằng cấu trúc khó hiểu có thể tăng lỗi.
- Đo điểm nóng: profile hoặc benchmark sau khi có phiên bản đúng; đừng tối ưu đoạn code chỉ vì Big O nghe ấn tượng.
- Kiểm tra trường hợp biên: rỗng, trùng khóa, dữ liệu xấu, giới hạn, phần tử bị xóa, chu trình và thứ tự bất định.
Nếu yêu cầu đổi, cấu trúc cũng có thể đổi. Ví dụ ban đầu chỉ cần duyệt danh sách nhỏ; sau đó sản phẩm cần truy vấn nhanh theo ID. Khi ấy có thể tạo chỉ mục phụ, nhưng phải quản lý cập nhật đồng bộ và nhất quán. Không có một lần chọn nào đúng mãi mà không cần xem lại khi tải và tính năng thay đổi.
Ví dụ: giỏ hàng và tìm kiếm
Giỏ hàng thường cần hiển thị các dòng theo thứ tự người dùng thêm và cập nhật số lượng theo mã sản phẩm. Một thiết kế có thể giữ danh sách dòng để render và dùng map tra nhanh mã sản phẩm sang dòng tương ứng. Đây là hai cấu trúc phục vụ hai thao tác khác nhau. Cần xác định điều gì xảy ra nếu cùng mã được thêm lần nữa: tăng số lượng hay tạo dòng riêng? Quyết định nghiệp vụ này ảnh hưởng bất biến dữ liệu, không thể giao cho cấu trúc tự chọn.
Với bài toán tìm đường trong bản đồ, biểu diễn giao lộ là đỉnh, đường đi là cạnh. Nếu mọi đường có chi phí như nhau, duyệt theo lớp bằng queue là hướng thường gặp để tìm số bước ít nhất. Nếu đường có trọng số khác nhau, thuật toán và cấu trúc hỗ trợ ưu tiên sẽ khác. Bài học là trước khi chọn kiểu collection, xác định quan hệ và tiêu chí tối ưu của bài toán.
Bài tập: thiết kế chức năng phát hiện người dùng đã tham gia một sự kiện. Hãy so sánh việc quét danh sách người đăng ký với việc giữ tập ID. Nêu chi phí cập nhật, tra cứu, xử lý trùng và điều kiện cần bảo toàn thứ tự. Sau đó viết test cho danh sách rỗng, ID trùng, ID không tồn tại và thêm/xóa đồng thời nếu ứng dụng hỗ trợ.
Lộ trình học và luyện tập
Học từng cấu trúc theo chu trình: hiểu mô hình, tự cài bản đơn giản, phân tích chi phí thao tác, dùng thư viện chuẩn, rồi giải bài có ngữ cảnh. Với array/list, thử xoay mảng, lọc và tìm; với stack/queue, kiểm tra dấu ngoặc và mô phỏng hàng chờ; với map/set, đếm tần suất và khử trùng; với tree, duyệt tiền/trung/hậu thứ tự; với graph, duyệt BFS/DFS và tìm thành phần liên thông.
Đừng chỉ chép bảng Big O. Hãy tự mô tả tại sao một thao tác cần quét hay cần dịch phần tử. So sánh trường hợp dữ liệu ít và dữ liệu lớn, rồi ghi lại đánh đổi. Viết test cho rỗng, phần tử đơn, trùng lặp, đầu/cuối và dữ liệu bất thường. Học một ngôn ngữ sâu trước để biết thư viện chuẩn hoạt động thế nào; sau đó các ngôn ngữ khác sẽ dễ tiếp cận hơn.
Khi gặp hệ thống lớn, tìm nơi cấu trúc dữ liệu xuất hiện: index trong cơ sở dữ liệu, cache key-value, queue message, cây cú pháp, graph phụ thuộc. Hiểu khái niệm giúp đọc kiến trúc tốt hơn nhưng không thay kiến thức vận hành cụ thể của công nghệ.
Câu hỏi thường gặp
Có cần học cấu trúc dữ liệu trước khi học lập trình?
Không cần học toàn bộ trước khi viết chương trình. Có thể bắt đầu với biến, mảng, vòng lặp rồi học cấu trúc khi bài toán yêu cầu. Nắm nền tảng sớm giúp chọn collection và giải thích vì sao giải pháp chậm hoặc khó bảo trì.
Cấu trúc dữ liệu nào quan trọng nhất?
Không có lựa chọn duy nhất. Array/list, map, set, stack, queue, tree và graph xuất hiện trong nhiều loại bài toán. Hãy học thao tác, bất biến và đánh đổi của từng loại, rồi chọn theo yêu cầu thực tế.
Học Big O có cần thiết không?
Cần biết để so sánh tốc độ tăng khi dữ liệu lớn lên, nhưng không nên xem Big O là thời gian chạy tuyệt đối. Hằng số, bộ nhớ, runtime và kích thước dữ liệu vẫn ảnh hưởng; đo hiệu năng khi tối ưu một hệ thống cụ thể.
Tại sao không dùng một list cho tất cả?
List thuận tiện nhưng có thể làm tra cứu, kiểm tra trùng hoặc xử lý ưu tiên tốn kém khi dữ liệu tăng. Dùng cấu trúc khác có thể giảm chi phí hoặc thể hiện đúng ý nghĩa, đổi lại có thể dùng thêm bộ nhớ và phức tạp cập nhật.
Cấu trúc dữ liệu và thuật toán khác nhau thế nào?
Cấu trúc dữ liệu tổ chức dữ liệu; thuật toán là quy trình thao tác hoặc giải bài toán trên dữ liệu đó. Hai khái niệm tương tác với nhau: cấu trúc phù hợp có thể giúp thuật toán thực hiện thao tác hiệu quả hơn.
Nên tự cài cấu trúc hay dùng thư viện?
Để học, tự cài bản nhỏ giúp hiểu nguyên lý. Trong ứng dụng thực tế, ưu tiên thư viện chuẩn đã được kiểm thử trừ khi có yêu cầu đặc thù. Kiểm tra tài liệu ngôn ngữ, độ an toàn và đặc tính triển khai.
Nguồn tham khảo
- OpenDSA — Data Structures and Algorithms — tài liệu giáo dục đại học về cấu trúc và thuật toán.

Bình luận (0
)